https://github.com/hosose/LOG_GEN/tree/bronze
GitHub - hosose/LOG_GEN at bronze
Contribute to hosose/LOG_GEN development by creating an account on GitHub.
github.com
안녕하세요! "Fargate와 Terraform으로 만드는 대용량 로그 생성기" 시리즈의 제6편입니다.
앞선 1~5편에서는 AWS Fargate와 CloudWatch Logs를 이용해 가상 로그를 생성하고 확인하는 애플리케이션 운영/디버깅 관점의 시스템을 구축했습니다.
이번 6편부터는 본격적인 데이터 엔지니어링(Data Engineering)의 세계로 진입합니다!
로그를 단순히 콘솔에 찍는 것에 그치지 않고, 메달리온 아키텍처(Medallion Architecture)의 첫 번째 관문인 브론즈 레이어(Bronze Layer, Raw Data Lake)를 구축하고 실시간 스트리밍 수집(Streaming Ingestion) 파이프라인을 완성해 보겠습니다.
왜 CloudWatch에서 Kinesis + S3로 전환해야 할까요?
소프트웨어 개발자 vs 데이터 엔지니어 관점의 차이
- 개발자 관점 (CloudWatch Logs): 애플리케이션 상태 모니터링, 에러 발생 시 원인 추적, 텍스트 기반 디버깅에 최적화되어 있습니다.
- 데이터 엔지니어 관점 (S3 Data Lake): 수억~수백억 건의 로그를 보관하고, SQL(Athena), Spark, Flink 등을 활용해 통계/집계/머신러닝/비즈니스 분석을 수행할 수 있어야 합니다.
S3에 바로 저장(Direct S3 Put)하면 안 되나요?
로그 생성기에서 S3로 직접 로그를 저장하면 두 가지 치명적인 문제가 발생합니다:
- 과도한 I/O 및 비용 발생: 로그 1건마다
PutObjectAPI를 호출하면 초당 수천 건 발생 시 API 호출 비용이 폭증합니다. - Small File Problem (작은 파일 문제): 몇 바이트짜리 수많은 작은 파일들이 S3에 쌓이면, 향후 Athena나 Spark 등으로 쿼리할 때 I/O 오버헤드로 심각한 성능 저하가 발생합니다.
해결책: Amazon Kinesis Data Streams + Amazon Data Firehose
- Kinesis Data Streams (KDS): 밀려드는 실시간 스트림 데이터를 유실 없이 고속으로 버퍼링
- Amazon Data Firehose (ADF): 데이터를 시간(60초) 또는 용량(1MB) 단위로 모아서(Micro-batch) S3에 대량 기록
- GZIP 압축 & 파티셔닝: 스토리지 비용을 70~80% 절감하고, 날짜/시간별 동적 파티셔닝 적용
1. 전체 스트리밍 아키텍처 다이어그램
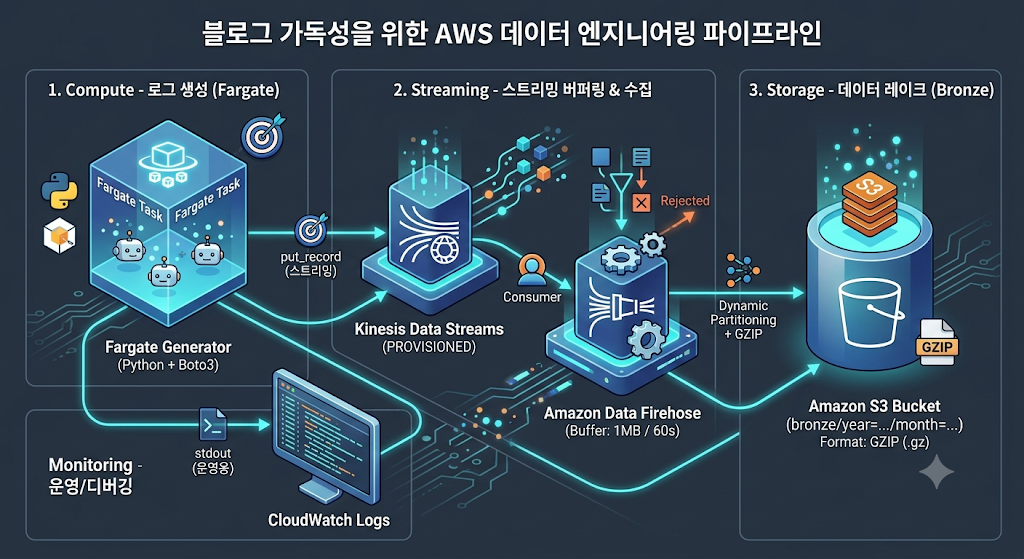
    subgraph Compute ["1. 로그 생성 (Fargate)"]
        A["Fargate Generator<br/>(Python + Boto3)"]
    end

    subgraph Streaming ["2. 스트리밍 버퍼링 & 수집"]
        B["Kinesis Data Streams<br/>(PROVISIONED)"]
        C["Amazon Data Firehose<br/>(Buffer: 1MB / 60s)"]
    end

    subgraph Storage ["3. 데이터 레이크 (Bronze)"]
        D[("Amazon S3 Bucket<br/>(bronze/year=.../month=...)<br/>Format: GZIP (.gz)")]
    end

    subgraph Monitoring ["운영/디버깅"]
        M["CloudWatch Logs"]
    end

    A -->|"stdout (운영용)"| M
    A -->|"put_record (스트리밍)"| B
    B -->|"Consumer"| C
C -->|"Dynamic Partitioning + GZIP"| D2. 메달리온 아키텍처 (Medallion Architecture) 란?
데이터 레이크하우스(Data Lakehouse)의 표준 품질 관리 패턴입니다.
| 단계 | 의미 | 저장 형태 및 포맷 | 뉘앙스 / 역할 |
|---|---|---|---|
| Bronze ⭐ (이번 편) | Raw Data (원본 데이터) | 원본 그대로, GZIP (jsonl.gz) |
"무슨 일이 일어났는가?" (가공되지 않은 순수 원본 보존) |
| Silver | Cleaned & Enriched | 정제/변환, Parquet (.parquet) |
"누가, 언제, 무엇을 했는가?" (분석 가능한 표준 테이블) |
| Gold | Business Aggregated | 마트/집계 테이블 (.parquet) |
"이번 시간 매출은 얼마인가?" (BI/대시보드 즉시 활용) |
3. 인프라 구축 (Terraform 코드 구현)
이번 단계에서 추가/수정된 테라폼 파일들의 핵심 내용을 살펴봅니다.
① Kinesis Data Stream (infra/kinesis.tf)
샤드 수를 직접 지정하는 프로비저닝(PROVISIONED) 모드로 스트림을 구성합니다.
# [브론즈 추가] Kinesis Data Stream (KDS)
resource "aws_kinesis_stream" "logs" {
  name             = local.kinesis_stream_name
  shard_count      = var.kinesis_shard_count
  retention_period = var.kinesis_retention_hour

  # 프로비저닝 모드로 구성 -> 샤드 수 직접 지정
  stream_mode_details {
    stream_mode = "PROVISIONED"
  }
}② S3 Data Lake 버킷 (infra/s3.tf)
브론즈, 실버, 골드 계층이 저장될 통합 데이터 레이크 S3 버킷을 정의하고 외부 퍼블릭 접근을 완전 차단합니다.
# [브론즈 추가] 데이터 레이크 S3 버킷
resource "aws_s3_bucket" "data" {
  bucket        = "${var.project_name}-s3-bk-${data.aws_caller_identity.current.account_id}"
  force_destroy = true # 실습용으로 삭제 시 내부 객체 자동 삭제
}

# 퍼블릭 엑세스 차단
resource "aws_s3_bucket_public_access_block" "data" {
  bucket                  = aws_s3_bucket.data.id
  block_public_acls       = true
  block_public_policy     = true
  ignore_public_acls      = true
  restrict_public_buckets = true
}③ Amazon Data Firehose & GZIP 압축 (infra/firehose.tf)
Kinesis로부터 데이터를 읽어와 버퍼링 후, S3에 연/월/일/시 계층 파티션으로 분기하여 GZIP 압축 저장합니다.
resource "aws_kinesis_firehose_delivery_stream" "logs" {
  name        = local.firehose_name
  destination = "extended_s3"

  # 입력 소스: Kinesis Stream
  kinesis_source_configuration {
    kinesis_stream_arn = aws_kinesis_stream.logs.arn
    role_arn           = aws_iam_role.firehose.arn
  }

  # 출력 대상: S3
  extended_s3_configuration {
    bucket_arn         = aws_s3_bucket.data.arn
    role_arn           = aws_iam_role.firehose.arn
    buffering_size     = var.firehose_buffer_size     # 1 MiB
    buffering_interval = var.firehose_buffer_interval # 60 초

    # GZIP 압축 포맷 지정
    compression_format = "GZIP"
    custom_time_zone   = "Asia/Seoul"

    # 동적 파티셔닝 접두사 (Athena 검색 성능 최적화: Partition Pruning)
    prefix              = "bronze/year=!{timestamp:yyyy}/month=!{timestamp:MM}/day=!{timestamp:dd}/hour=!{timestamp:HH}/"
    error_output_prefix = "error/!{firehose:error-output-type}/year=!{timestamp:yyyy}/month=!{timestamp:MM}/day=!{timestamp:dd}/hour=!{timestamp:HH}/"
  }

  depends_on = [aws_iam_role_policy.firehose]
}④ IAM 권한 설정 (infra/iam.tf)
- Firehose: Kinesis 스트림 읽기(
kinesis:GetRecords등) 및 S3 쓰기(s3:PutObject) 권한 부여 - ECS Task: Fargate 컨테이너 내부에서 Kinesis로 데이터를 쓸 수 있도록
kinesis:PutRecord,kinesis:PutRecords권한을Task Role로 부여
4. Python 로그 생성기 코드 수정
① 의존성 추가 (generator/requirements.txt)
AWS SDK인 boto3를 추가합니다.
Faker
boto3② 출력기 수정 (generator/app/output.py)
기존 콘솔/파일 출력에 더해 Kinesis 스트림으로 실시간 레코드를 쏘는 기능을 추가합니다.
import os
import json
import boto3
from typing import TextIO

class JsonlOutput:
    def __init__(self, mode: str, log_file: str,
                 kinesis_enabled: bool = False, kinesis_stream_name: str = ""):
        self.mode = mode
        self.log_file = log_file
        self.kinesis_enabled = kinesis_enabled
        self.kinesis_stream_name = kinesis_stream_name
        self._handle: TextIO | None = None

        # Kinesis 클라이언트 초기화
        self._kinesis = boto3.client("kinesis") if self.kinesis_enabled else None

    def emit(self, event: dict, malformed_json: bool = False) -> None:
        line = json.dumps(event, ensure_ascii=False)
        if malformed_json:
            line = line[:max(1, int(len(line) * 0.7))]

        # 1. stdout 콘솔 출력 (CloudWatch로 전달)
        if self.mode in {"stdout", "both"}:
            print(line, flush=True)

        # 2. 파일 출력
        if self._handle is not None:
            self._handle.write(line + os.linesep)

        # 3. Kinesis 실시간 스트림 전송
        if self._kinesis:
            self._kinesis.put_record(
                StreamName   = self.kinesis_stream_name,
                Data         = (line + "\n").encode("utf-8"),
                PartitionKey = str(event.get("domain", "default")) # 도메인별 샤드 파티셔닝
)5. 배포 및 실전 테스트
1) 테라폼 인프라 배포
terraform -chdir=infra apply2) 도커 이미지 빌드 및 ECR 푸시
# Windows
scripts\setup.bat

# Mac/Linux
sh scripts/setup.sh3) Fargate 로그 생성기 가동
# ecommerce 도메인, 5초 동안 초당 5건 생성 (총 25건 로그 전송)
scripts\run-generator.bat ecommerce 5 5 0.05 1 ap-northeast-2 14) S3 Bronze 데이터 적재 확인
Firehose의 버퍼링 시간(60초)이 경과한 후 S3 버킷을 조회합니다.
# S3 버킷 내 저장된 파일 확인
aws s3 ls s3://de-ai-07-loggen-s3-bk-827913617635/bronze/ --recursive출력 결과:
2026-08-20 15:31:30 782 bronze/year=2026/month=08/day=20/hour=15/de-ai-07-loggen-firehose-3-2026-08-20-15-30-28-00497aef-2785-48e5-8f59-e6bab2038917.gzS3의 bronze/ 경로 하위에 날짜별 파티션과 함께 .gz 압축 파일이 정상 적재되었습니다! 🎉
6. 핵심 인사이트 정리
- GZIP 압축 포맷의 효과:
- JSON 구조의 텍스트 로그는 키 이름의 반복이 많아 GZIP 압축 시 약 70~85% 용량이 감소합니다.
- 이는 S3 저장 요금뿐 아니라, 향후 AWS Athena로 쿼리할 때 스캔 데이터량($5/TB 과금)을 획기적으로 줄여 비용을 대폭 절감합니다.
- 동적 파티셔닝(Dynamic Partitioning)과 Partition Pruning:
- S3 경로를
year=YYYY/month=MM/day=DD/hour=HH/형태로 계층화하여 저장하면, 쿼리 엔진이 특정 날짜/시간 범위만 콕 집어서 읽을 수 있어 검색 속도가 비약적으로 향상됩니다.
- S3 경로를
7. 다음 단계 예고 (Next Step)
이제 우리의 데이터 레이크에 원천 데이터(Bronze Layer)가 안전하게 쌓이기 시작했습니다.
다음 7편에서는 이 Bronze 데이터를 가져와 SILVER 데이터로 변형하는 작업을 해보겠습니다.
'코딩 개발 > Date Engineer' 카테고리의 다른 글
| NumPy 공부 2부 — ndarray 만드는 방법과 shape, reshape 제대로 이해하기 (0) | 2026.10.06 |
|---|---|
| NumPy 공부 1부 — 데이터 분석을 시작하면 왜 NumPy부터 배우는 걸까? (0) | 2026.10.05 |
| [5편] Docker 컨테이너 빌드부터 AWS ECS 1-Click 대량 실행 파이프라인까지 (0) | 2026.10.01 |
| [4편] Terraform으로 100% 코드로 찍어내는 AWS 서버리스 인프라 (IaC) (0) | 2026.09.30 |
| [3편] 데이터 엔지니어의 숙명: 결측치와 이상치(오염 데이터) 의도적 주입 기법 (0) | 2026.09.29 |