지난 글에서는 NumPy가 왜 필요한지, 그리고 NumPy의 핵심 자료구조인 ndarray가 무엇인지 살펴봤습니다.
이번에는 한 단계 더 들어가서 NumPy 배열을 실제로 어떻게 만드는지 공부해보려고 합니다.
처음 NumPy를 배우다 보면 배열 하나를 만드는 함수가 생각보다 많아서 조금 당황하게 됩니다.
np.array()
np.asarray()
np.arange()
np.zeros()
np.ones()
np.empty()
np.eye()
np.identity()
np.random.randn()
처음에는 이런 생각이 들었습니다.
“그냥
np.array()하나만 있으면 되는 것 아닌가?”
그런데 하나씩 살펴보니 각 함수마다 사용하는 목적이 조금씩 달랐습니다.
그리고 이번 글에서 개인적으로 가장 중요하다고 느낀 부분은 reshape()였습니다.
배열을 만들 줄 아는 것보다,
현재 데이터가 어떤 모양이고, 원하는 형태로 어떻게 바꿀 것인가
를 이해하는 것이 더 중요해 보였습니다.
하나씩 정리해보겠습니다.
1. 가장 기본적인 배열 생성 — np.array()
가장 먼저 알아야 하는 것은 역시 np.array()입니다.
파이썬 리스트를 NumPy의 ndarray로 변환할 수 있습니다.
import numpy as np

datas = [1, 2, 3]

arr = np.array(datas)
이제 arr는 일반적인 파이썬 리스트가 아니라 NumPy 배열입니다.
type(arr)
결과는 다음과 같습니다.
<class 'numpy.ndarray'>
1차원 리스트뿐만 아니라 2차원 리스트도 배열로 만들 수 있습니다.
datas = [
    [1, 2, 3],
    [4, 5, 6]
]

arr = np.array(datas)이 배열의 정보를 확인해보겠습니다.
arr
arr.shape
arr.ndim
arr.dtypeshape은
(2, 3)
이 됩니다.
즉,
2개의 행
3개의 열을 가지고 있는 2차원 배열입니다.
지난 글에서 살펴봤던 shape, ndim, dtype이 여기서 다시 등장합니다.
NumPy를 공부하다 보니 배열을 만들고 나서
arr.shape
arr.ndim
arr.dtype을 확인하는 습관이 꽤 중요하다는 생각이 들었습니다.
2. np.array()와 np.asarray()는 뭐가 다를까요?
이번에 공부하면서 조금 헷갈렸던 부분입니다.
NumPy에는
np.array()뿐만 아니라
np.asarray()라는 함수도 있습니다.
둘 다 데이터를 NumPy 배열 형태로 만들 수 있습니다.
그런데 기존 NumPy 배열을 전달했을 때 복사가 발생하는지 여부에서 차이가 생길 수 있습니다.
예제로 살펴보겠습니다.
먼저 배열을 하나 만듭니다.
arr = np.array([
    [1, 2, 3],
    [4, 5, 6]
])그리고 다시 np.array()로 배열을 만들어보겠습니다.
arr2 = np.array(arr)이후 arr2의 값을 수정합니다.
arr2[0][0] = 100확인해보면
arr
arr2두 배열이 별도로 존재하는 것을 확인할 수 있습니다.
즉, 이런 경우 arr2를 수정했다고 해서 원본 arr가 같이 바뀌지는 않습니다.
np.asarray()는 조금 다르게 동작할 수 있습니다
이번에는 다음과 같이 만들어보겠습니다.
arr3 = np.asarray(arr2)그리고 값을 수정합니다.
arr3[0][0] = 101이후
arr2
arr3를 확인하면 같은 데이터가 영향을 받는 모습을 볼 수 있습니다.
왜 이런 일이 생길까요?
np.asarray()는 입력값이 이미 적절한 NumPy 배열이라면 불필요한 복사를 피하고 기존 데이터를 활용할 수 있기 때문입니다.
처음에는 별것 아닌 차이처럼 보였는데 데이터가 커진다고 생각해보니 이야기가 달라집니다.
예를 들어 수 GB의 데이터를 매번 복사한다면 메모리를 상당히 많이 사용할 수 있습니다.
그래서 데이터 처리에서는
원본을 별도로 유지해야 하는가?
        ↓
복사가 필요한가?

아니면

불필요한 복사를 줄이는 것이 중요한가?같은 부분도 생각해야 할 것 같습니다.
다만 여기서 한 가지 중요한 점이 있습니다.
np.array()와 np.asarray()의 복사 여부는 입력값과 옵션에 따라 달라질 수 있기 때문에,
array = 무조건 복사asarray = 무조건 얕은 복사
처럼 외우기보다는 기존 ndarray를 다시 배열로 받을 때 불필요한 복사를 피할 수 있는 함수가 asarray()라고 이해하는 편이 좋겠습니다.
3. 연속된 숫자가 필요할 때 — np.arange()
다음은 정말 자주 사용할 것 같은 함수입니다.
np.arange()이름을 처음 봤을 때는 조금 낯설었는데 Python의 range()와 비슷하게 생각하면 이해하기 쉽습니다.
np.arange(5)결과는 다음과 같습니다.
[0 1 2 3 4]즉,
0 <= x < 5범위의 숫자를 만들어줍니다.
시작값과 끝값을 직접 지정할 수도 있습니다.
np.arange(0, 5, 1)결과는 동일하게
[0 1 2 3 4]가 됩니다.
형태는 다음처럼 생각하면 됩니다.
np.arange(시작값, 끝값, 간격)간격도 직접 지정할 수 있습니다
NumPy의 arange()는 정수뿐만 아니라 다음처럼 소수 단위의 간격도 사용할 수 있습니다.
np.arange(0, 5, 0.5)결과는 대략 다음과 같습니다.
[0. 0.5 1. 1.5 2. 2.5 3. 3.5 4. 4.5]이런 방식은 일정한 간격의 데이터를 만들어야 할 때 사용할 수 있습니다.
나중에 그래프를 그리거나 테스트 데이터를 만들 때도 활용할 수 있을 것 같습니다.
4. reshape() — 배열의 모양을 바꾸기
여기부터 이번 글에서 가장 중요하다고 느꼈던 부분입니다.
바로
reshape()입니다.
이름 그대로 해석하면
re + shape

다시 + 형태정도로 이해할 수 있습니다.
즉,
배열 안의 데이터를 유지하면서 배열의 모양을 다시 구성하는 것
입니다.
먼저 숫자 16개를 만들어보겠습니다.
arr = np.arange(16)결과는 다음과 같습니다.
[0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15]현재 shape을 확인하면
arr.shape결과는
(16,)입니다.
1차원 배열입니다.
1차원 배열을 2차원으로 바꿔보겠습니다
arr.reshape(4, 4)결과는 다음과 같은 형태가 됩니다.
[
 [ 0,  1,  2,  3],
 [ 4,  5,  6,  7],
 [ 8,  9, 10, 11],
 [12, 13, 14, 15]
]shape은
(4, 4)입니다.
숫자는 그대로 16개인데 배열의 형태만 바뀌었습니다.
3차원으로도 바꿀 수 있습니다
같은 16개의 숫자를 다음처럼 만들 수도 있습니다.
np.arange(16).reshape(2, 2, 4)shape은
(2, 2, 4)가 됩니다.
계산해보면
2 × 2 × 4 = 16입니다.
여기서 중요한 규칙이 하나 보입니다.
reshape에서는 전체 데이터 개수가 맞아야 합니다
기존 데이터가 16개라면 새로운 shape의 각 숫자를 곱한 결과도 16이어야 합니다.
예를 들어
4 × 4 = 16이므로 가능합니다.
2 × 2 × 4 = 16도 가능합니다.
하지만
3 × 4 = 12이므로 데이터 16개를
np.arange(16).reshape(3, 4)처럼 바꾸려고 하면 맞지 않습니다.
쉽게 말하면 상자 모양은 바꿀 수 있지만 상자 안에 들어 있는 물건의 개수가 갑자기 늘어나거나 줄어들 수는 없는 것과 비슷합니다.
그런데 reshape(-1, 8)의 -1은 무엇일까요?
처음 코드를 봤을 때 가장 궁금했던 부분이었습니다.
np.arange(16).reshape(-1, 8)갑자기 -1이 등장합니다.
처음에는
“행의 개수가 -1개라는 뜻인가?”
싶었습니다.
당연히 그런 의미는 아닙니다.
NumPy에서 reshape()에 -1을 넣으면
이 부분의 크기는 NumPy가 전체 데이터 개수에 맞춰 자동으로 계산해주세요.
라는 의미입니다.
숫자가 총 16개 있고 한 행에 8개씩 넣겠다고 했으니 NumPy가 계산합니다.
? × 8 = 16

? = 2따라서
np.arange(16).reshape(-1, 8)은 사실상
np.arange(16).reshape(2, 8)과 같은 형태가 됩니다.
결과는
[
 [ 0,  1,  2,  3,  4,  5,  6,  7],
 [ 8,  9, 10, 11, 12, 13, 14, 15]
]입니다.
이 -1은 앞으로 데이터 분석이나 머신러닝에서도 자주 볼 것 같습니다.
5. 0으로 채워진 배열 만들기 — np.zeros()
이번에는 조금 특이한 배열을 만들어보겠습니다.
np.zeros((2, 3))결과는 다음과 같습니다.
[
 [0. 0. 0.],
 [0. 0. 0.]
]shape은
(2, 3)이고 내부 값은 모두 0입니다.
처음에는
“굳이 전부 0인 배열을 왜 만들지?”
라는 생각이 들었습니다.
하지만 실제 데이터 처리나 계산에서는 먼저 필요한 크기의 공간을 만들고 이후 값을 채워 넣는 방식이 필요할 수 있습니다.
그래서 zeros() 같은 함수가 존재한다고 이해했습니다.
6. 1로 채워진 배열 — np.ones()
이번에는 모두 1로 만들어보겠습니다.
np.ones((2, 3))
결과는
[
 [1. 1. 1.],
 [1. 1. 1.]
]입니다.
zeros()와 사용법은 거의 같습니다.
np.zeros((행, 열))
np.ones((행, 열))처럼 사용할 수 있습니다.
7. 값보다 모양이 중요하다면 — np.empty()
이번에는
np.empty((2, 3))를 살펴보겠습니다.
이름만 보면
“빈 배열이 만들어지는 건가?”
라는 생각이 듭니다.
하지만 실제로 실행해보면 배열 안에 어떤 숫자가 들어 있을 수 있습니다.
중요한 것은 empty()가 배열 공간을 만들 때 값을 0이나 1로 초기화하는 것을 목적으로 하지 않는다는 점입니다.
즉,
어차피 바로 새로운 값을 넣을 것이고, 우선 필요한 shape의 배열 공간만 준비하면 된다
는 상황에서 사용할 수 있습니다.
그래서 empty()를 사용할 때는 안에 들어 있는 초기값을 의미 있는 데이터라고 생각하면 안 됩니다.
zeros_like(), ones_like(), empty_like()
비슷한 함수가 하나 더 있습니다.
np.zeros_like()
np.ones_like()
np.empty_like()기존 배열과 같은 shape과 dtype을 바탕으로 새로운 배열을 만드는 데 유용합니다.
예를 들어
arr = np.ones((2, 3))이라는 배열이 있다면,
arr2 = np.zeros_like(arr)라고 할 수 있습니다.
확인해보면
arr.shape
arr2.shape둘 다
(2, 3)입니다.
기존 데이터와 똑같은 구조의 배열이 필요한 경우 편리하게 사용할 수 있을 것 같습니다.
8. 대각선만 1인 배열 — np.eye()
다음은 조금 독특합니다.
np.eye(3, 3)실행하면 다음과 비슷한 배열이 만들어집니다.
[
 [1. 0. 0.],
 [0. 1. 0.],
 [0. 0. 1.]
]대각선은 1이고 나머지는 0입니다.
수학에서 말하는 단위행렬(Identity Matrix) 형태입니다.
eye()는 꼭 정사각형일 필요는 없습니다.
np.eye(3, 4)처럼 만들 수도 있습니다.
궁금해서 찾아본 내용... ㅎㅎ
np.eye()의 eye는 영어 “eye”의 발음이 알파벳 “I”와 같기 때문입니다.
수학에서 단위행렬(Identity matrix)을 보통 I라고 표현합니다.
np.identity()도 있습니다
비슷한 함수로
np.identity(4)가 있습니다.
결과는 4 × 4 단위행렬입니다.
[
 [1. 0. 0. 0.],
 [0. 1. 0. 0.],
 [0. 0. 1. 0.],
 [0. 0. 0. 1.]
]둘이 비슷해 보이지만 차이가 있습니다.
np.eye()는
np.eye(3, 4)처럼 직사각형 형태도 만들 수 있지만,
np.identity()는 기본적으로
n × n형태의 정사각형 단위행렬을 만듭니다.
현재 단계에서는 선형대수를 깊게 들어가기보다는
대각선이 1이고 나머지가 0인 특별한 행렬도 NumPy에서 쉽게 만들 수 있다.
정도로 기억해두려고 합니다.
9. 랜덤 데이터를 만들어보겠습니다
데이터 공부를 하다 보면 테스트를 위해 임의의 데이터가 필요할 때가 있습니다.
이때 NumPy의 랜덤 기능을 사용할 수 있습니다.
학습 자료에서는 다음과 같은 예제를 사용했습니다.
arr = np.random.randn(2, 3, 4)shape을 확인하면
arr.shape결과는
(2, 3, 4)입니다.
즉 3차원 배열이 만들어집니다.
randn()은 평균이 0이고 표준편차가 1인 표준정규분포에서 난수를 생성합니다.
그래서 실행할 때마다 값이 달라질 수 있습니다.
예를 들어 대략 이런 형태의 숫자가 나옵니다.
0.32
-1.14
0.75
-0.28
...양수도 있고 음수도 있습니다.
랜덤 배열도 일반 배열과 똑같이 계산할 수 있습니다
예를 들어
arr >= 0이라고 하면 어떻게 될까요?
배열 안의 모든 값을 대상으로
0 이상인가?를 확인합니다.
결과는 숫자가 아니라 Boolean 배열이 됩니다.
예를 들어,
[
 [ True, False, True ],
 [ False, True, True ]
]같은 형태입니다.
이 부분이 다음 글에서 공부할 Boolean Indexing과도 이어집니다.
조건에 맞는 데이터만 골라낼 수 있기 때문입니다.
여기까지 공부하고 나니 배열을 보는 방식이 조금 달라졌습니다
처음 NumPy를 접했을 때는
np.array([1, 2, 3])정도만 알면 배열을 만드는 건 끝이라고 생각했습니다.
하지만 실제로는 목적에 따라 다양한 방법이 있었습니다.
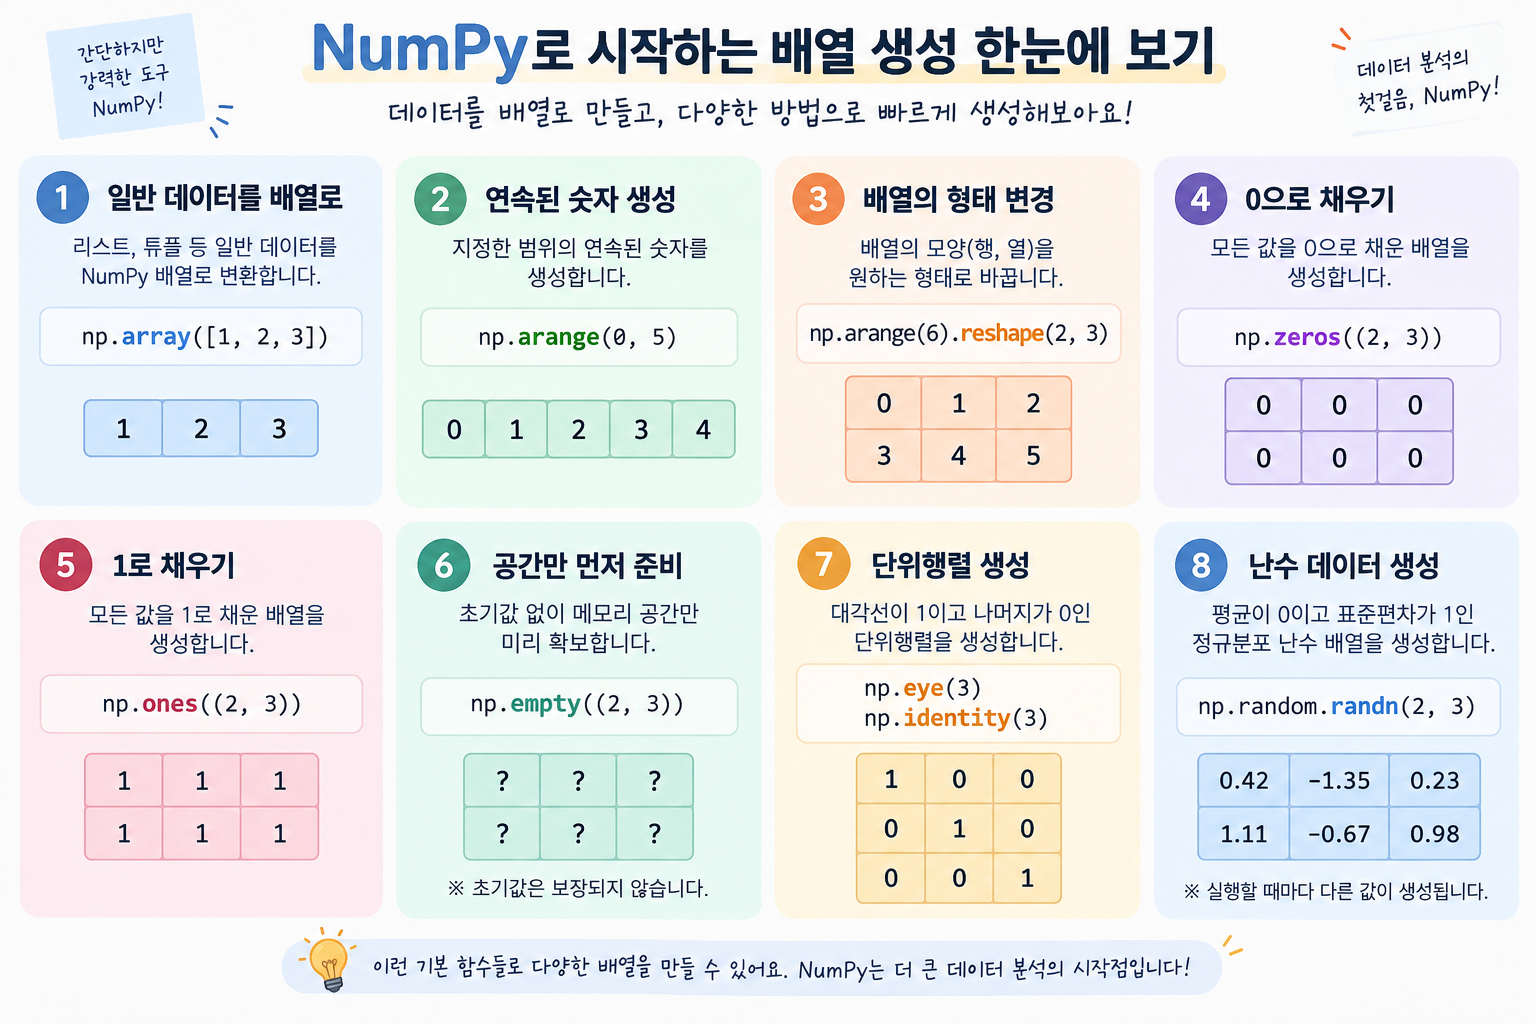
정리해보면 다음과 같습니다.
일반 데이터를 배열로
        ↓
    np.array()

연속된 숫자 생성
        ↓
    np.arange()

배열의 형태 변경
        ↓
    reshape()

0으로 채우기
        ↓
    np.zeros()

1로 채우기
        ↓
    np.ones()

공간만 먼저 준비
        ↓
    np.empty()

단위행렬 생성
        ↓
 np.eye()
 np.identity()

난수 데이터 생성
        ↓
np.random.randn()특히 이번에 공부하면서 가장 중요하다고 느낀 것은 shape이었습니다.
NumPy에서는 결국
데이터가 몇 개인가?

↓

현재 어떤 모양인가?

↓

어떤 모양으로 바꿀 것인가?를 계속 생각하게 되는 것 같습니다.
개인적으로 reshape(-1, 8)은 꼭 기억해두려고 합니다
이번 내용에서 하나만 기억하라고 한다면 저는 이 코드를 기억할 것 같습니다.
np.arange(16).reshape(-1, 8)
처음 보면 -1 때문에 굉장히 어려운 문법처럼 보입니다.
하지만 의미는 생각보다 단순했습니다.
전체 데이터 = 16개

열 = 8개

행 = 알아서 계산해주세요그러면 NumPy가
16 ÷ 8 = 2를 계산해서
(2, 8)형태로 만들어줍니다.
결국 reshape()에서 가장 중요한 것은
전체 원소의 개수는 그대로 유지해야 한다
는 것입니다.
이 원리를 이해하고 나니 reshape()가 조금 덜 어렵게 느껴졌습니다.
다음 글에서 공부할 내용
이번 글에서는 NumPy 배열을 만드는 여러 가지 방법을 살펴봤습니다.
다음 3부에서는 본격적으로 배열을 계산하는 방법을 공부해보려고 합니다.
예를 들어 다음과 같은 연산입니다.
arr + 10
arr - 10
arr * 10
arr / 10
처음 NumPy를 접하면 신기한 부분 중 하나가 배열 전체에 숫자 하나를 바로 더하거나 곱할 수 있다는 점입니다.
그리고 더 중요한 내용이 등장합니다.
바로
브로드캐스팅(Broadcasting)
입니다.
크기가 서로 다른 두 배열도 일정한 규칙을 만족하면 연산할 수 있다고 하는데, 처음 보면 꽤 헷갈리는 개념입니다.
다음 글에서는
배열과 스칼라 연산
배열과 배열 연산
브로드캐스팅
dtype
int8 / int16 / int32 / int64
float32 / float64까지 하나씩 정리해보겠습니다.
'코딩 개발 > Date Engineer' 카테고리의 다른 글
| NumPy 공부 4부 — 인덱싱, 슬라이싱, Boolean Indexing으로 원하는 데이터 꺼내기 (0) | 2026.10.08 |
|---|---|
| NumPy 공부 3부 — 배열 연산과 브로드캐스팅, dtype을 이해해보자 (0) | 2026.10.07 |
| NumPy 공부 1부 — 데이터 분석을 시작하면 왜 NumPy부터 배우는 걸까? (0) | 2026.10.05 |
| [6편] CloudWatch에서 Kinesis + S3 Data Lake (Bronze Layer) 스트리밍 파이프라인 구축하기 (0) | 2026.10.02 |
| [5편] Docker 컨테이너 빌드부터 AWS ECS 1-Click 대량 실행 파이프라인까지 (0) | 2026.10.01 |