요즘 데이터 관련 공부를 시작하면서 NumPy를 처음 제대로 접하게 되었습니다.
사실 처음에는 조금 의문이 들었습니다.
“파이썬에는 리스트가 있는데 굳이 NumPy라는 걸 또 배워야 하나?”
숫자를 여러 개 저장하는 거라면 그냥 리스트에 넣으면 되고, 반복문으로 계산하면 되는 것 아닌가 싶었습니다.
그런데 공부를 조금 해보니 NumPy는 단순히 숫자를 담는 또 하나의 자료구조가 아니었습니다.
Pandas를 비롯한 데이터 분석 도구부터 머신러닝, 딥러닝까지 이어지는 과정에서 꽤 중요한 기반 역할을 하고 있었습니다.
이번 글에서는 NumPy 문법부터 바로 들어가기보다는 먼저,
- 데이터를 처리할 때 어떤 것을 고려해야 하는지
- NumPy, Pandas, Polars, Spark는 무엇이 다른지
- NumPy가 왜 빠른지
- ndarray는 무엇인지
- shape, ndim, dtype은 왜 확인하는지
이 부분부터 하나씩 정리해보려고 합니다.
저도 처음 배우는 입장에서 정리하는 글이라, 최대한 어려운 용어를 그대로 외우기보다는 “그래서 이게 왜 필요한 걸까?”라는 관점에서 이해해보려고 합니다.
1. 데이터를 다룰 때는 무조건 Pandas를 쓰는 게 아니었습니다
데이터 분석이라고 하면 가장 먼저 Pandas를 떠올리는 경우가 많습니다.
저 역시 그랬습니다.
CSV 파일 하나 불러와서
import pandas as pd

df = pd.read_csv("data.csv")이렇게 시작하면 되는 줄 알았습니다.
물론 데이터 규모가 크지 않다면 실제로 이것만으로도 상당히 많은 일을 할 수 있습니다.
그런데 데이터가 커지기 시작하면 이야기가 달라집니다.
데이터를 처리하기 전에 적어도 다음과 같은 것들을 생각해야 합니다.
데이터의 형태
먼저 데이터가 어떤 구조로 되어 있는지를 봐야 합니다.
예를 들어,
1, 2, 3, 4, 5처럼 단순한 숫자의 나열일 수도 있고,
이름 | 나이 | 지역 | 매출처럼 행과 열로 구성된 표 형태일 수도 있습니다.
이미지라면 가로 × 세로 × 채널처럼 여러 차원의 숫자로 표현될 수도 있습니다.
즉, 데이터라고 해서 모두 같은 구조는 아닙니다.
2. 데이터의 크기도 중요합니다
두 번째는 데이터 규모입니다.
1MB짜리 CSV 파일을 처리하는 것과 500GB짜리 데이터를 처리하는 것은 전혀 다른 문제입니다.
개인 PC의 메모리가 16GB인데 100GB짜리 데이터를 한 번에 메모리에 올리려고 하면 당연히 문제가 생길 수 있습니다.
그래서 데이터를 처리할 때는 단순히
“어떤 라이브러리가 편한가?”
만 생각하는 것이 아니라,
“내가 처리해야 하는 데이터는 어느 정도 크기인가?”
를 같이 생각해야 합니다.
이 부분을 공부하면서 Pandas, Polars, Spark가 왜 따로 존재하는지도 조금 이해가 되었습니다.
NumPy, Pandas, Polars, Spark는 무엇이 다를까요?
대략적인 성격을 먼저 정리하면 다음처럼 이해할 수 있습니다.
| 도구 | 핵심 자료구조 | 특징 |
|---|---|---|
| NumPy | ndarray | 빠른 수치 계산, 다차원 배열 |
| Pandas | Series, DataFrame | 표 형태 데이터 분석과 전처리 |
| Polars | DataFrame | 병렬 처리와 쿼리 최적화에 강점 |
| Spark | DataFrame, RDD 등 | 여러 컴퓨터를 이용한 대규모 분산 처리 |
여기서 중요한 것은 누가 더 좋고 나쁘고의 문제는 아니라는 점입니다.
처리하려는 데이터와 환경에 맞는 도구를 선택하는 문제에 가깝습니다.
NumPy
NumPy는 주로 다차원 배열을 이용한 빠른 수치 계산에 사용됩니다.
핵심 자료구조가 ndarray입니다.
import numpy as np

arr = np.array([1, 2, 3])
이렇게 만들면 파이썬 리스트가 NumPy 배열이 됩니다.
처음 봤을 때는 솔직히
[1, 2, 3]이나
np.array([1, 2, 3])이나 별 차이가 없어 보였습니다.
하지만 데이터가 커지고 계산이 많아지면 차이가 생깁니다.
NumPy는 배열 전체를 대상으로 효율적인 수치 연산을 수행하도록 설계되어 있습니다.
Pandas
Pandas는 우리가 흔히 접하는 표 형태의 데이터를 다루기에 훨씬 편합니다.
예를 들어 주식 데이터를 생각하면 이해하기 쉽습니다.
| 날짜 | 종가 | 거래량 |
|---|---|---|
| 2026-09-01 | 70,000 | 10,000,000 |
| 2026-09-02 | 71,000 | 12,000,000 |
| 2026-09-03 | 69,500 | 9,000,000 |
이런 데이터를 처리할 때는 NumPy 배열보다 Pandas의 DataFrame이 훨씬 직관적입니다.
df["종가"].mean()
처럼 특정 컬럼을 이름으로 선택할 수도 있습니다.
다만 Pandas는 일반적인 사용 방식에서는 데이터를 메모리에 올려 처리하기 때문에 데이터가 아주 커지면 메모리 사용량이 문제가 될 수 있습니다.
Polars
Polars는 공부하면서 처음 알게 된 도구였습니다.
Pandas와 비슷하게 DataFrame을 사용하지만 Rust로 구현되어 있고, 멀티코어 활용과 쿼리 최적화, Lazy Execution 같은 기능을 적극적으로 활용합니다.
쉽게 말하면,
“해야 할 작업을 먼저 모아놓고, 어떻게 실행하는 것이 효율적인지 생각한 다음 처리한다.”
정도로 이해하면 될 것 같습니다.
예를 들어 여러 번 필터링하고 컬럼을 선택하는 작업을 한다면 모든 중간 결과를 무조건 하나씩 만들어내기보다 전체 작업 계획을 보고 최적화할 수 있습니다.
이런 방식을 지연 실행(Lazy Execution)이라고 합니다.
물론 “데이터가 크면 무조건 Polars”라고 단순하게 생각하면 안 됩니다.
데이터 구조, 사용하는 기능, 메모리, 주변 생태계 등도 같이 봐야 합니다.
그래도 대용량 데이터를 한 대의 컴퓨터에서 효율적으로 처리해야 한다면 상당히 흥미로운 선택지라는 생각이 들었습니다.
Spark
Spark부터는 규모가 또 달라집니다.
NumPy, Pandas, Polars를 주로 한 대의 컴퓨터에서 사용하는 상황과 달리 Spark는 여러 컴퓨터를 하나의 클러스터로 묶어 데이터를 분산 처리할 수 있습니다.
예를 들어 1TB의 데이터를 처리해야 한다고 생각해보겠습니다.
내 컴퓨터 한 대의 메모리가 32GB라면 단순하게 전부 올려서 처리하기 어렵습니다.
이때 여러 서버에 데이터를 나누고,
서버 1 → 데이터 일부 처리
서버 2 → 데이터 일부 처리
서버 3 → 데이터 일부 처리
서버 4 → 데이터 일부 처리각각 계산한 결과를 다시 합치는 식의 분산 처리가 필요해질 수 있습니다.
Spark는 이런 환경을 위해 만들어진 프레임워크라고 이해하면 됩니다.
그래서 어떤 걸 사용해야 할까요?
현재까지 공부한 내용을 아주 단순화하면 저는 이렇게 이해했습니다.
숫자 배열과 계산
        ↓
      NumPy
        ↓
표 형태 데이터 분석
        ↓
      Pandas
        ↓
더 큰 데이터를 한 머신에서 효율적으로
        ↓
      Polars
        ↓
여러 서버를 이용해야 할 정도의 데이터
        ↓
Spark물론 현실에서는 이렇게 정확하게 경계가 나뉘지는 않습니다.
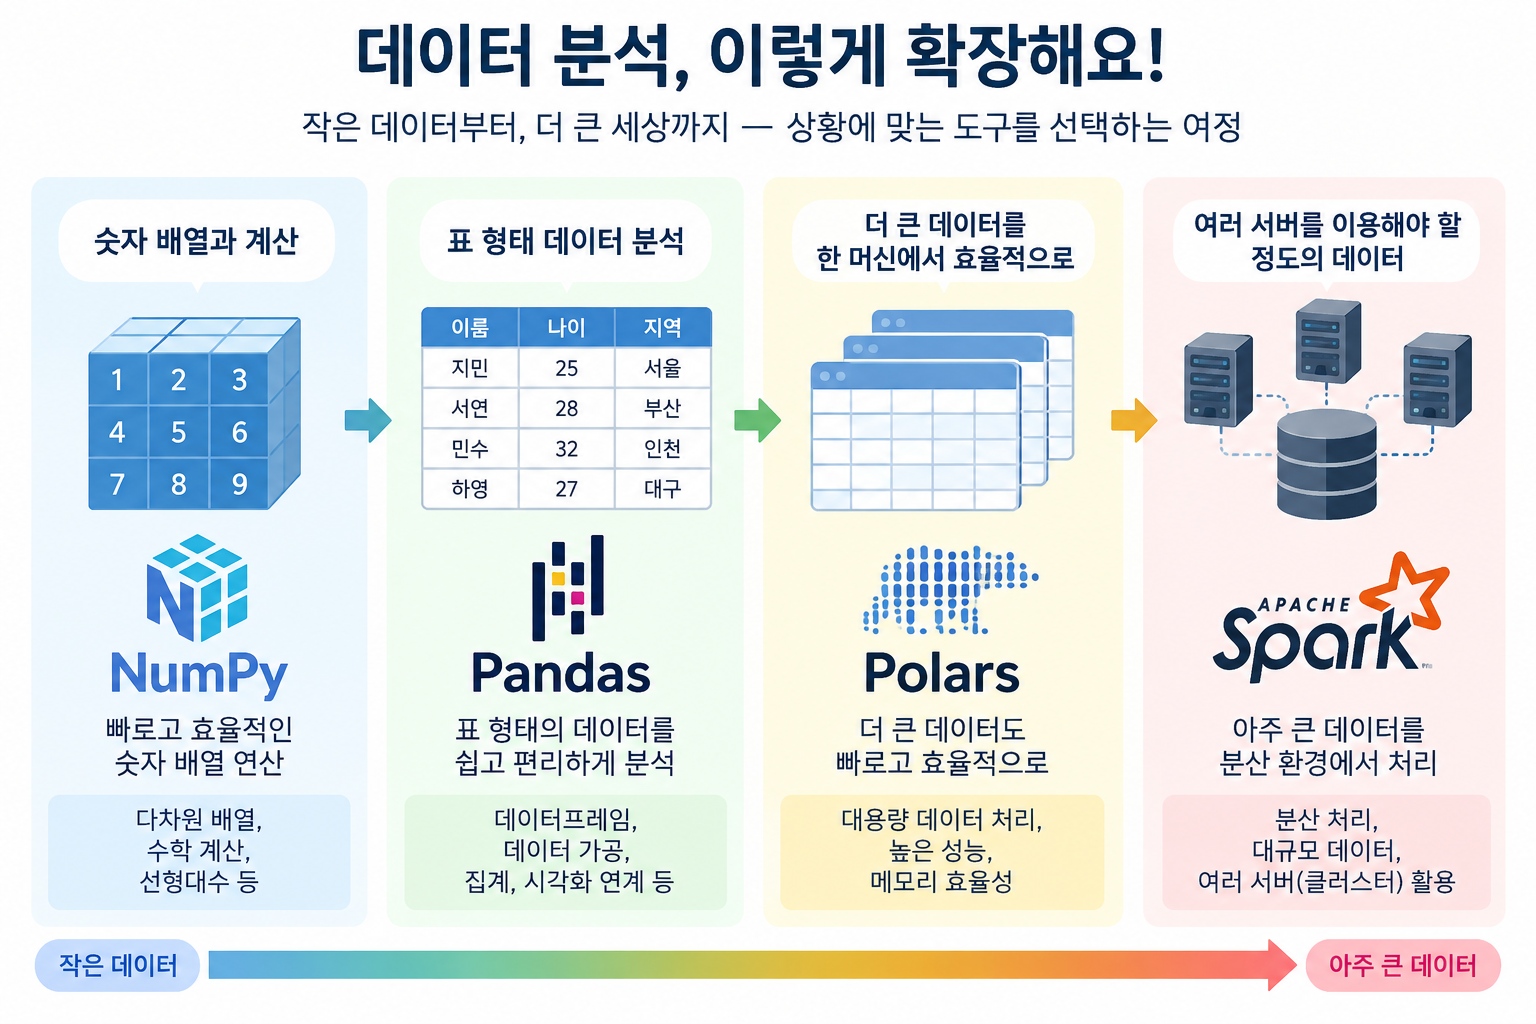
Pandas로 수십 GB 데이터를 처리하는 경우도 있을 것이고, Polars를 작은 데이터에 사용할 수도 있습니다.
따라서 이것은 절대적인 기준이라기보다는 각 도구의 성격을 이해하기 위한 그림 정도로 보면 좋을 것 같습니다.
그럼 다시 NumPy로 돌아가보겠습니다
NumPy의 공식적인 설명을 보면 다음과 같은 표현이 나옵니다.
The fundamental package for scientific computing with Python
즉, 파이썬에서 과학 계산을 하기 위한 핵심 패키지라는 의미입니다.
NumPy라는 이름 역시
Numerical Python에서 나온 이름입니다.
말 그대로 숫자 계산을 위한 파이썬 도구입니다.
그런데 중요한 부분이 하나 있습니다.
NumPy를 단순히
“수학 계산할 때 사용하는 라이브러리”
라고만 알고 넘어가면 NumPy가 왜 중요한지 제대로 이해하기 어렵습니다.
핵심은 배열을 이용해 많은 숫자를 효율적으로 계산한다는 것입니다.
파이썬 리스트와 NumPy 배열
파이썬에는 이미 리스트가 있습니다.
numbers = [1, 2, 3, 4, 5]
그런데 NumPy에서는 같은 데이터를 다음과 같이 만듭니다.
import numpy as np

numbers = np.array([1, 2, 3, 4, 5])
왜 이렇게 해야 할까요?
가장 큰 이유 가운데 하나가 계산 효율입니다.
예를 들어 모든 값에 10을 곱한다고 해보겠습니다.
파이썬 리스트에서는 보통 다음과 같이 작성합니다.
numbers = [1, 2, 3, 4, 5]

result = []

for number in numbers:
    result.append(number * 10)
또는 리스트 컴프리헨션을 사용할 수도 있습니다.
result = [number * 10 for number in numbers]
NumPy에서는 이렇게 할 수 있습니다.
numbers = np.array([1, 2, 3, 4, 5])

result = numbers * 10
결과는
[10 20 30 40 50]입니다.
처음 봤을 때 이 부분이 꽤 신기했습니다.
배열 자체에 10을 곱했는데 배열 안에 있는 모든 숫자에 10이 곱해졌습니다.
이런 방식이 이후에도 계속 등장합니다.
NumPy가 빠른 이유
여기서 궁금증이 하나 생깁니다.
파이썬으로 만든 라이브러리인데 어떻게 파이썬 반복문보다 빠를까요?
NumPy의 핵심 연산 상당 부분은 파이썬 레벨에서 하나씩 반복하는 방식이 아니라 최적화된 저수준 코드에서 수행됩니다.
또 하나 중요한 이유가 데이터를 저장하는 방식입니다.
일반적인 파이썬 리스트는 여러 종류의 객체를 담을 수 있습니다.
data = [1, "hello", 3.14, True]정수, 문자열, 실수, Boolean이 한 리스트 안에 들어갈 수 있습니다.
매우 편리합니다.
하지만 이런 유연성을 제공하기 위해 각각의 원소가 파이썬 객체로 관리되는 특성이 있습니다.
반면 NumPy의 ndarray는 일반적으로 하나의 배열 안에서 같은 dtype의 데이터를 연속적으로 다루도록 설계되어 있습니다.
예를 들어
arr = np.array([1, 2, 3])이라고 하면 배열의 dtype은 보통 정수형이 됩니다.
arr.dtype처럼 확인할 수 있습니다.
이처럼 일정한 자료형을 가진 데이터를 조밀하게 저장하고, 내부에서 최적화된 반복 연산을 수행할 수 있기 때문에 대량의 숫자 계산에서 강점을 가집니다.
그래서 단순히
“NumPy는 파이썬보다 50배 빠르다.”
처럼 숫자 하나로 외우기보다는,
많은 수치 데이터를 반복 계산할수록 파이썬 객체를 하나씩 처리하는 방식보다 NumPy의 배열 연산이 유리할 수 있다.
정도로 이해하는 것이 더 정확할 것 같습니다.
실제 속도 차이는 연산의 종류, 배열 크기, 데이터 타입, 하드웨어 등에 따라 크게 달라질 수 있습니다.
ndarray가 NumPy의 핵심입니다
NumPy를 공부하면서 가장 먼저 익숙해져야 하는 것이 바로 ndarray입니다.
이름을 풀어보면
n-dimensional array
즉,
n차원 배열 이라는 뜻입니다.
1차원이 될 수도 있고,
2차원이 될 수도 있고,
3차원 이상의 배열도 만들 수 있습니다.
0차원, 1차원, 2차원은 무엇일까요?
처음에는 이 부분이 조금 헷갈렸습니다.
쉽게 그림으로 생각해보겠습니다.
0차원: Scalar
숫자 하나입니다.
10이를 Scalar, 즉 스칼라라고 합니다.
1차원: Vector
숫자가 한 줄로 나열되어 있습니다.
[1, 2, 3]이를 벡터라고 생각할 수 있습니다.
코드로 만들면
arr = np.array([1, 2, 3])입니다.
2차원: Matrix
행과 열이 생깁니다.
[
    [1, 2, 3],
    [4, 5, 6]
]코드로 작성하면
arr = np.array([
    [1, 2, 3],
    [4, 5, 6]
])입니다.
우리가 엑셀이나 데이터베이스에서 보는 표와 비슷한 모습입니다.
그래서 2차원 데이터는 데이터 분석과 머신러닝에서 정말 많이 접하게 됩니다.
3차원 이상
여기서 한 차원을 더 추가할 수도 있습니다.
arr = np.array([
    [
        [1, 2],
        [3, 4]
    ],
    [
        [5, 6],
        [7, 8]
    ]
])처음 보면 상당히 복잡해 보입니다.
그런데 이미지 데이터를 생각하면 조금 이해하기 쉽습니다.
흑백 이미지 한 장을 숫자로 표현한다면
높이 × 너비의 2차원 구조로 생각할 수 있습니다.
RGB 컬러 이미지라면
높이 × 너비 × 3처럼 채널이라는 차원이 하나 더 생길 수 있습니다.
여러 장의 이미지를 한 번에 처리하면 또 하나의 차원이 추가될 수도 있습니다.
결국 머신러닝과 딥러닝에서 NumPy와 비슷한 다차원 배열 구조를 계속 만나게 되는 이유입니다.
자연어도 결국 숫자로 바뀝니다
개인적으로 이 부분이 꽤 재미있었습니다.
컴퓨터 입장에서는 우리가 쓰는
"오늘 날씨가 좋다"라는 문장을 그 의미 그대로 계산할 수 없습니다.
결국 머신러닝 모델에 넣으려면 숫자로 표현해야 합니다.
즉,
문장
 ↓
토큰
 ↓
숫자
 ↓
벡터같은 과정을 거치게 됩니다.
요즘 자주 듣는 임베딩(Embedding)이나 Vector Database도 결국 이런 숫자로 표현된 벡터와 관련되어 있습니다.
물론 NumPy 배열 하나를 만든다고 바로 RAG나 LLM이 되는 것은 아닙니다.
하지만 지금 배우는
스칼라
벡터
행렬
다차원 배열개념이 나중에 머신러닝과 딥러닝으로 연결된다는 점은 기억해둘 만합니다.
이쯤 되니 NumPy가 조금 중요하게 느껴지기 시작했습니다.
배열을 하나 만들어보겠습니다
이제 실제 배열을 만들어보겠습니다.
NumPy는 보통 다음과 같이 불러옵니다.
import numpy as np
왜 np라고 할까요?
특별한 문법은 아닙니다.
as np
를 통해 numpy라는 이름 대신 np라는 짧은 별명을 사용하는 것입니다.
NumPy 생태계에서 사실상 관례처럼 사용됩니다.
버전은 다음처럼 확인할 수 있습니다.
np.__version__파이썬 리스트를 ndarray로 변환하기
먼저 일반 리스트를 만듭니다.
datas = [1, 2, 3]
그리고 np.array()에 전달합니다.
arr = np.array(datas)
이제 arr는 일반적인 파이썬 리스트가 아니라 NumPy의 ndarray입니다.
확인해보면
type(arr)
결과는 대략 다음과 같습니다.
<class 'numpy.ndarray'>
이렇게 RAW 데이터를 NumPy 배열로 바꾸고 나면 NumPy가 제공하는 각종 배열 계산을 사용할 수 있게 됩니다.
배열을 만들었으면 이것부터 확인해보겠습니다
강의에서 배열을 만든 후 다음 값들을 확인했는데, 처음에는 왜 이렇게 여러 개를 한꺼번에 보는지 잘 이해되지 않았습니다.
arr
arr.shape
type(arr)
arr.ndim
arr.dtype
하나씩 살펴보니 상당히 중요한 정보였습니다.
type(arr) — 이 객체가 무엇인가요?
type(arr)
객체의 파이썬 타입을 확인합니다.
NumPy 배열이라면
numpy.ndarray
임을 확인할 수 있습니다.
arr.shape — 데이터는 어떤 모양인가요?
이 부분이 상당히 중요합니다.
arr = np.array([1, 2, 3])에서
arr.shape를 확인하면
(3,)이 나옵니다.
데이터가 3개 있는 1차원 배열이라는 의미입니다.
2차원 배열을 만들어보겠습니다.
arr = np.array([
    [1, 2, 3],
    [4, 5, 6]
])
shape을 확인하면
arr.shape
결과는
(2, 3)입니다.
즉,
2개의 행
3개의 열을 가진 배열입니다.
처음에는 (2, 3)이 별것 아닌 정보처럼 보이지만 머신러닝과 딥러닝으로 가면 shape 오류를 정말 자주 만나게 됩니다.
예를 들어 두 배열의 크기가 맞지 않으면 연산 자체가 되지 않을 수도 있습니다.
그래서 데이터를 받으면
“이 데이터의 shape이 어떻게 되어 있지?”
를 먼저 확인하는 습관이 꽤 중요해 보입니다.
ndim — 몇 차원인가요?
arr.ndim은 배열의 차원 수를 알려줍니다.
np.array([1, 2, 3]).ndim은
1이고,
np.array([
    [1, 2, 3],
    [4, 5, 6]
]).ndim은
2입니다.
여기서 shape과 ndim을 혼동하기 쉽습니다.
예를 들어
shape = (1000, 20)이라고 해서 1000차원이나 20차원이라는 뜻은 아닙니다.
괄호 안의 값이 두 개이므로 2차원 배열입니다.
ndim  = 2
shape = (1000, 20)이런 관계입니다.
dtype — 데이터의 자료형은 무엇인가요?
마지막으로
arr.dtype이 있습니다.
NumPy 배열 내부의 데이터 타입을 확인합니다.
예를 들어
arr = np.array([1, 2, 3])이라면 정수 타입이 사용됩니다.
NumPy에서 dtype이 중요한 이유는 단순히
“정수냐 실수냐”
를 확인하기 위해서만은 아닙니다.
자료형에 따라 메모리 사용량과 표현할 수 있는 값의 범위가 달라지기 때문입니다.
이 부분은 뒤에서
int8
int16
int32
int64

float32
float64같은 자료형을 공부하면서 조금 더 자세히 살펴볼 예정입니다.
여기까지 공부하고 NumPy를 다시 보니
처음 NumPy를 봤을 때는 사실 이런 느낌이었습니다.
배열 하나 만들려고 라이브러리까지 써야 하나?
그런데 데이터 처리 전체 흐름에서 생각해보니 조금 다르게 보였습니다.
NumPy는 단순히 배열을 저장하기 위한 도구가 아니라,
많은 수치 데이터를 일정한 구조로 저장하고 빠르게 계산하기 위한 기반 도구에 가깝습니다.
그리고 이 개념이 Pandas, 머신러닝, 딥러닝으로 계속 이어집니다.
현재까지의 흐름을 정리하면 다음과 같습니다.
데이터
  ↓
어떤 형태인가?
  ↓
얼마나 큰가?
  ↓
한 대의 컴퓨터에서 처리할 수 있는가?
  ↓
어떤 도구를 사용할 것인가?
  ↓
NumPy / Pandas / Polars / Spark
그리고 NumPy 안으로 들어가면
데이터
  ↓
ndarray
  ↓
shape
ndim
dtype
  ↓
벡터·행렬 연산으로 이어집니다.
아직은 정말 입구에 들어온 정도입니다.
하지만 앞으로 reshape, 배열 연산, 브로드캐스팅, 인덱싱 같은 내용을 이해하려면 오늘 정리한 ndarray, shape, ndim, dtype 개념을 먼저 제대로 알고 있어야 할 것 같습니다.
다음 글에서 공부할 내용
다음 2부에서는 NumPy 배열을 만드는 여러 가지 방법을 정리해보려고 합니다.
단순히 np.array()만 사용하는 것이 아니라
np.array()
np.asarray()
np.arange()
np.zeros()
np.ones()
np.empty()
np.eye()
np.identity()
np.random.randn()등이 각각 무엇인지 살펴볼 예정입니다.
그리고 NumPy를 처음 보면 꼭 헷갈리는
reshape()도 같이 공부해보려고 합니다.
특히
np.arange(16).reshape(-1, 8)에서 갑자기 등장하는 -1이 대체 무슨 의미인지도 다음 글에서 천천히 정리해보겠습니다.
'코딩 개발 > Date Engineer' 카테고리의 다른 글
| NumPy 공부 3부 — 배열 연산과 브로드캐스팅, dtype을 이해해보자 (0) | 2026.10.07 |
|---|---|
| NumPy 공부 2부 — ndarray 만드는 방법과 shape, reshape 제대로 이해하기 (0) | 2026.10.06 |
| [6편] CloudWatch에서 Kinesis + S3 Data Lake (Bronze Layer) 스트리밍 파이프라인 구축하기 (0) | 2026.10.02 |
| [5편] Docker 컨테이너 빌드부터 AWS ECS 1-Click 대량 실행 파이프라인까지 (0) | 2026.10.01 |
| [4편] Terraform으로 100% 코드로 찍어내는 AWS 서버리스 인프라 (IaC) (0) | 2026.09.30 |