안녕하세요! "Fargate와 Terraform으로 만드는 대용량 로그 생성기" 시리즈의 마지막인 제5편에 오신 것을 환영합니다.
앞선 편들에서 우리는 다음과 같은 내용들을 배웠습니다.
- 1~3편: 파이썬(
Python)과 통계학(포아송/지수분포)을 활용해 4대 도메인의 리얼한 트래픽 및 오염 데이터를 생성하는 원리 - 4편: 테라폼(
Terraform) 코드를 이용해 AWS VPC, ECR, ECS Fargate 등 클라우드 인프라를 자동으로 생성하는 방법
이제 이번 5편에서는 우리가 작성한 파이썬 코드를 도커(Docker) 컨테이너로 포장하고, 스크립트 단 한 줄로 AWS Fargate에서 수백~수만 건의 로그를 대량 생성하는 1-Click 실행 파이프라인을 완성해 보겠습니다.
초보자분들도 쉽게 따라오실 수 있도록, 파일 하나하나의 역할과 코드 한 줄 한 줄의 의미를 친절하게 설명해 드릴게요!
🧭 전체 실행 흐름 한눈에 보기
우리가 진행할 배포 및 실행 파이프라인의 전체 그림은 다음과 같습니다.
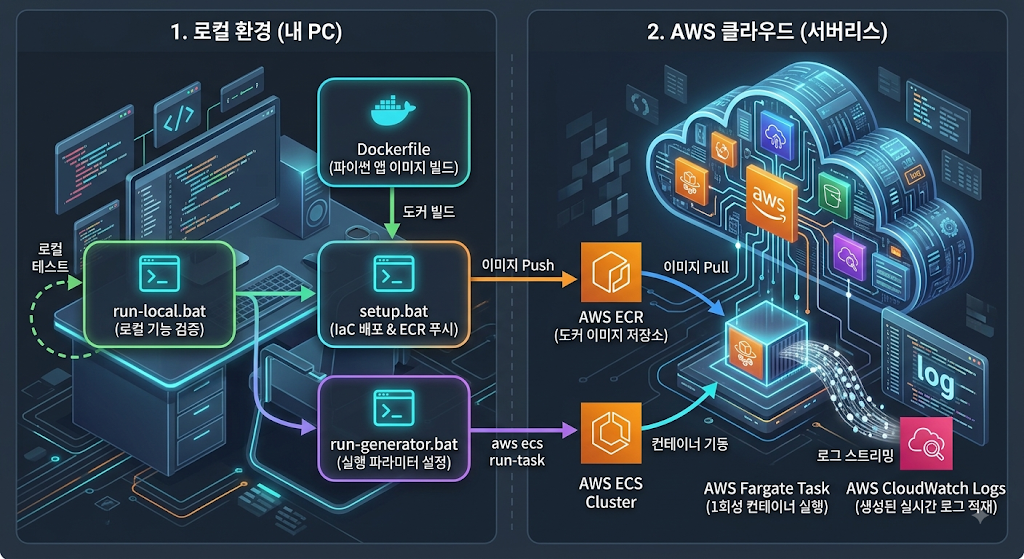
    subgraph Local ["1. 로컬 환경 (내 PC)"]
        A["run-local.bat\n(로컬 기능 검증)"]
        B["Dockerfile\n(파이썬 앱 이미지 빌드)"]
        C["setup.bat\n(IaC 배포 & ECR 푸시)"]
        D["run-generator.bat\n(실행 파라미터 설정)"]
    end

    subgraph AWS ["2. AWS 클라우드 (서버리스)"]
        E[("AWS ECR\n(도커 이미지 저장소)")]
        F["AWS ECS Cluster"]
        G["AWS Fargate Task\n(1회성 컨테이너 실행)"]
        H["AWS CloudWatch Logs\n(생성된 실시간 로그 적재)"]
    end

    A -. 로컬 테스트 .-> A
    B -->|도커 빌드| C
    C -->|이미지 Push| E
    D -->|aws ecs run-task| F
    E -->|이미지 Pull| G
    F -->|컨테이너 기동| G
G -->|로그 스트리밍| H1. 파이썬 앱을 컨테이너로 만들기: generator/Dockerfile
❓ 도커(Docker)와 Dockerfile이 왜 필요한가요?
"내 컴퓨터에서는 잘 돌아가는데, 다른 컴퓨터나 AWS 서버에 올리면 에러가 나요!"라는 문제를 겪어보신 적 있으신가요?
도커(Docker)는 파이썬 버전, 필요한 패키지(requirements.txt), 소스 코드를 하나의 가벼운 '컨테이너 상자(Image)'로 꽁꽁 포장해 주는 기술입니다.
그리고 이 상자를 만드는 레시피(설명서)가 바로 Dockerfile입니다.
📄 코드 살펴보기 (generator/Dockerfile)
# 1. 베이스 이미지 설정: 가볍고 빠른 Python 3.12 슬림 버전 사용
FROM python:3.12-slim

# 2. 파이썬 실행 환경변수 설정
ENV PYTHONDONTWRITEBYTECODE=1 \
    PYTHONUNBUFFERED=1

# 3. 컨테이너 내부 작업 디렉터리 생성 및 이동
WORKDIR /app

# 4. 필수 라이브러리 목록 복사 및 설치
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# 5. 우리가 작성한 로그 생성기 파이썬 코드 복사
COPY app ./app

# 6. 컨테이너가 시작될 때 자동으로 실행할 기본 명령어
ENTRYPOINT [ "python", "-m", "app.main" ]🔍 한 줄씩 뜯어보기
FROM python:3.12-slim: 불필요한 기능이 빠진 초경량 리눅스 기반 파이썬 환경을 가져옵니다. 이미지 용량이 작아져서 다운로드와 배포가 매우 빨라집니다.ENV PYTHONDONTWRITEBYTECODE=1: 파이썬 실행 시 생기는.pyc임시 바이트코드 파일 생성을 방지하여 컨테이너를 깔끔하게 유지합니다.ENV PYTHONUNBUFFERED=1: 파이썬의print()출력이 버퍼에 머물지 않고 즉시 터미널/AWS 로그로 쏟아져 나오게 만듭니다. (실시간 로그 수집에 필수!)COPY requirements.txt .&RUN pip install ...: 필요한 라이브러리(Faker 등)를 먼저 설치합니다.COPY app ./app: 완성된 로그 생성기 소스 코드를 컨테이너 안으로 복사합니다.ENTRYPOINT [ "python", "-m", "app.main" ]: 컨테이너가 켜지는 즉시app.main모듈을 실행하도록 시작 명령을 지정합니다.
💡 Tip: Docker 레이어 캐싱(Layer Caching)
왜 소스 코드(COPY app)보다requirements.txt와pip install을 먼저 실행했을까요?
도커는 변경되지 않은 줄의 결과를 기억(캐싱)합니다. 라이브러리는 자주 바뀌지 않지만 소스 코드는 자주 수정되므로, 라이브러리 설치를 위에 두면 매번 무거운pip install을 다시 하지 않아 빌드 속도가 수십 배 빨라집니다!
2. 클라우드 올리기 전 내 PC에서 먼저 확인하기: scripts/run-local.bat
AWS에 바로 올렸다가 코드에 버그가 있으면 클라우드 비용과 시간이 낭비됩니다. 그래서 로컬 PC에서 먼저 빠르게 테스트해 볼 수 있는 배치 스크립트가 준비되어 있습니다.
📄 코드 살펴보기 (scripts/run-local.bat)
@echo off
setlocal EnableExtensions
chcp 65001 >nul

rem 1. 인자값(옵션) 받기 및 기본값 설정
set "DOMAIN=%~1"
if not defined DOMAIN set "DOMAIN=ecommerce"
set "DURATION_SECONDS=%~2"
if not defined DURATION_SECONDS set "DURATION_SECONDS=30"
set "BASE_RPS=%~3"
if not defined BASE_RPS set "BASE_RPS=2.0"
set "CORRUPTION_RATE=%~4"
if not defined CORRUPTION_RATE set "CORRUPTION_RATE=0.03"
set "OUTPUT_MODE=%~5"
if not defined OUTPUT_MODE set "OUTPUT_MODE=both"
set "TIME_SCALE=%~6"
if not defined TIME_SCALE set "TIME_SCALE=1.0"

rem ... (도메인 검증 및 출력 폴더 생성) ...

rem 2. 파이썬 및 Faker 설치 여부 사전 체크
where python >nul 2>&1
if errorlevel 1 (
  echo [ERROR] Python not found.
  exit /b 1
)

python -c "import faker" >nul 2>&1
if errorlevel 1 (
  echo [ERROR] Faker is not installed.
  echo         python -m pip install -r "%GENERATOR%\requirements.txt"
  exit /b 1
)

rem 3. 로그 생성기 실행!
pushd "%GENERATOR%"
python -m app.main
popd🚀 로컬 실행 방법
터미널(CMD 또는 PowerShell)에서 아래 명령어를 실행해 보세요.
# 사용법: run-local.bat [도메인] [실행시간(초)] [초당생성량(RPS)] [오염률] [출력방식] [시간배율]
scripts\run-local.bat ecommerce 10 2 0.05 both 1ecommerce도메인의 로그를10초동안- 초당
2건(RPS)속도로 5%의 의도적 오염 데이터를 섞어서- 화면 콘솔과 파일(
output/폴더의.jsonl) 둘 다(both)에 출력합니다!
💡 Tip: .bat 파일이란?
Windows 명령 프롬프트(CMD)에서 여러 개의 명령어를 차례대로 한 번에 실행해 주는 윈도우용 스크립트 파일입니다. (Mac/Linux에서는.sh쉘 스크립트를 사용합니다.)
3. 1-Click 인프라 생성 및 도커 배포: scripts/setup.bat
이제 로컬 테스트가 끝났으니, AWS에 인프라를 올리고 도커 이미지를 업로드할 차례입니다. setup.bat 스크립트는 복잡한 4가지 과정을 버튼 하나 누르듯 한 번에 끝내줍니다.
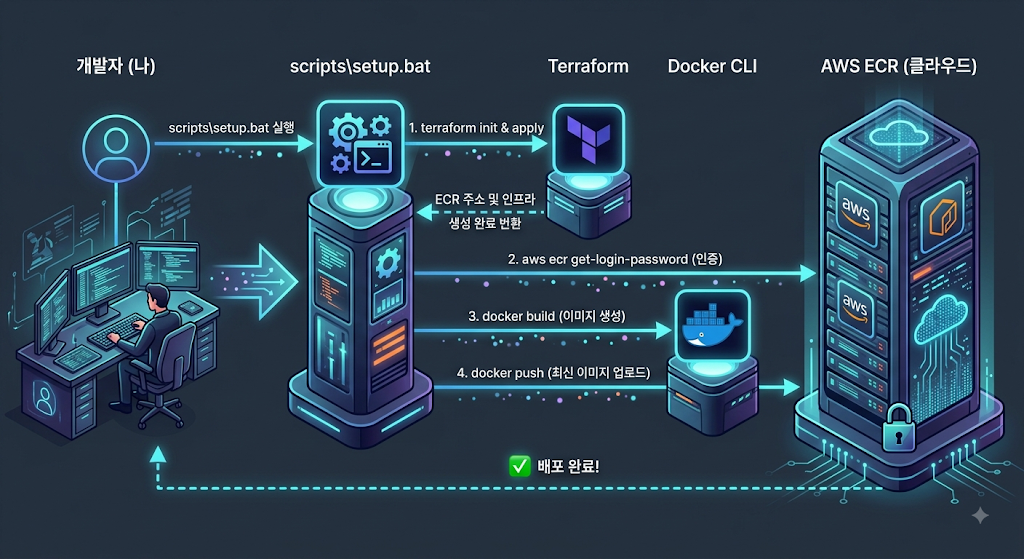
    autonumber
    actor User as 개발자 (나)
    participant Setup as setup.bat
    participant TF as Terraform
    participant Docker as Docker CLI
    participant ECR as AWS ECR (클라우드)

    User->>Setup: scripts\setup.bat 실행
    Setup->>TF: 1. terraform init & apply
    TF-->>Setup: ECR 주소 및 인프라 생성 완료 반환
    Setup->>ECR: 2. aws ecr get-login-password (인증)
    Setup->>Docker: 3. docker build (이미지 생성)
    Setup->>ECR: 4. docker push (최신 이미지 업로드)
ECR-->>User: ✅ 배포 완료!📄 핵심 동작 원리 (scripts/setup.bat)
- 사전 프로그램 확인:
aws,terraform,docker가 PC에 제대로 설치되어 있는지 검사합니다. - Terraform Apply (
infra/): 테라폼으로 AWS VPC, IAM 권한, ECR 저장소, ECS 클러스터 등을 자동 생성합니다. - ECR 주소 가져오기: 테라폼이 생성한 ECR Repository의 고유 URL 주소를 읽어옵니다.
- ECR 로그인 (
aws ecr get-login-password): 도커가 AWS ECR에 이미지를 올릴 수 있도록 임시 비밀번호로 로그인합니다. - Docker Build & Push:
generator/Dockerfile을 기반으로 도커 이미지를 빌드하고, AWS ECR 저장소로 푸시(push)합니다.
🚀 배포 실행하기
scripts\setup.bat ap-northeast-2잠시 기다리면 AWS에 모든 기반 환경 구축과 도커 이미지 등록이 자동으로 완료됩니다!
4. 대망의 AWS Fargate 대량 로그 생성 실행: scripts/run-generator.bat
모든 준비가 끝났습니다! 이제 AWS 서버리스 컨테이너인 Fargate에게 *"로그 10,000건 생성하고 작업 끝나면 컨테이너 종료해!"*라고 명령을 내릴 차례입니다.
❓ 왜 상시 가동 서버가 아니라 Fargate '1회성 태스크(Task)'인가요?
24시간 켜두는 일반 EC2 가상서버는 로그를 안 만들 때도 계속 비용이 발생합니다.
반면 AWS Fargate Run-Task 방식은 로그 생성을 시작할 때 컨테이너가 켜지고, 정해진 시간(예: 300초)이 지나 작업이 끝나면 컨테이너가 스스로 소멸합니다. 딱 실행된 몇 분 동안의 CPU/메모리 비용(몇십 원 수준)만 청구되므로 엄청나게 경제적입니다! 💰
📄 코드의 핵심 마법: containerOverrides (scripts/run-generator.bat)
run-generator.bat 파일에는 아주 영리한 기법이 들어있습니다.
이미지에 고정된 설정값을 사용하는 대신, 명령어를 실행할 때마다 동적으로 환경변수를 바꿔서 주입(Override)할 수 있습니다.
{
  "containerOverrides": [
    {
      "name": "log-generator",
      "environment": [
        {"name":"DOMAIN","value":"ecommerce"},
        {"name":"DURATION_SECONDS","value":"300"},
        {"name":"BASE_RPS","value":"2.0"},
        {"name":"TIME_SCALE","value":"1.0"},
        {"name":"CORRUPTION_RATE","value":"0.03"},
        {"name":"INCLUDE_CORRUPTION_LABEL","value":"false"},
        {"name":"OUTPUT_MODE","value":"stdout"},
        {"name":"RUN_ID","value":"loggen-98213"}
      ]
    }
  ]
}이 임시 JSON 파일을 만든 후, AWS CLI 명령어로 Fargate를 호출합니다.
aws ecs run-task ^
  --region "%REGION%" ^
  --cluster "%CLUSTER%" ^
  --launch-type FARGATE ^
  --task-definition "%TASK_DEFINITION%" ^
  --count "%TASK_COUNT%" ^
  --network-configuration "awsvpcConfiguration={subnets=[%SUBNET_CSV%],securityGroups=[%SECURITY_GROUP%],assignPublicIp=ENABLED}" ^
--overrides "file://%OVERRIDE_FILE%"🚀 AWS에서 대량 로그 생성 실행하기
# 문법: run-generator.bat [도메인] [시간(초)] [RPS] [오염률] [컨테이너개수] [리전] [시간배율]

# 예시 1: 이커머스 로그를 300초 동안 1개 컨테이너에서 생성
scripts\run-generator.bat ecommerce 300 2.0 0.03

# 예시 2: 금융(finance) 로그를 5개 컨테이너를 동시에 띄워 대규모 병렬 생성!
scripts\run-generator.bat finance 600 5.0 0.05 5 ap-northeast-2 1💡 Tip: 대규모 트래픽 부하 테스트 (Scale-Out)
TASK_COUNT를 5로 주면 Fargate 컨테이너 5개가 동시에 뜨면서 5배의 트래픽을 순식간에 뿜어냅니다. 카프카(Kafka)나 키네시스(Kinesis) 등 대용량 분산 파이프라인의 수용 한계를 테스트할 때 엄청나게 유용합니다!
5. 클라우드에 생성된 실시간 로그 확인하기
컨테이너가 stdout(표준 출력)으로 뿜어내는 로그들은 테라폼에서 설정한 AWS CloudWatch Logs에 실시간으로 수집됩니다.
💻 터미널에서 실시간 로그 스트리밍 확인하기
AWS 웹 콘솔에 들어가지 않고도 터미널에서 바로 확인할 수 있습니다:
aws logs tail "/ecs/de-ai-07-loggen" --follow --region ap-northeast-2터미널에 실제 서비스 환경처럼 살아 숨 쉬는 JSON 형태의 로그들이 실시간으로 쏟아져 들어오는 것을 보실 수 있습니다! ✨
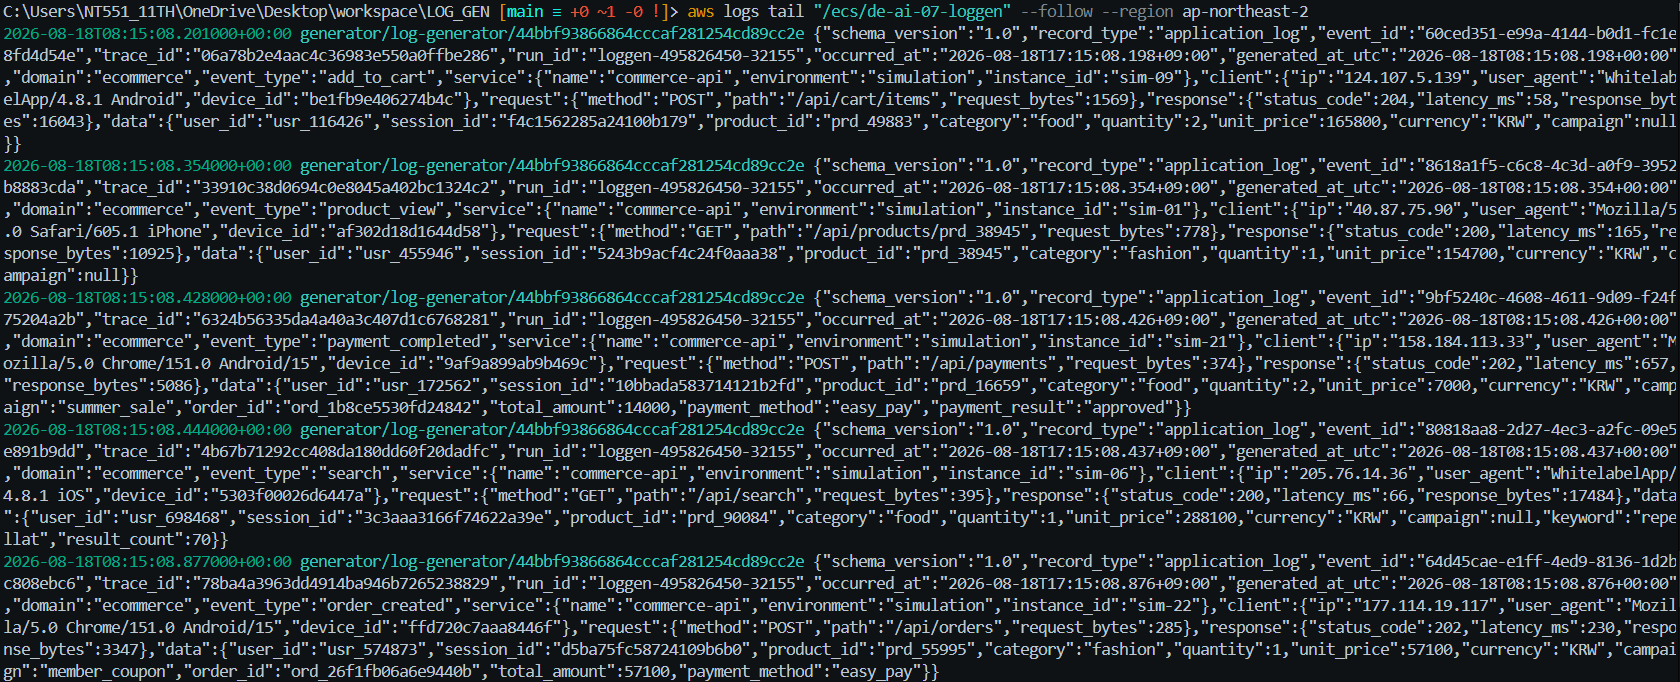
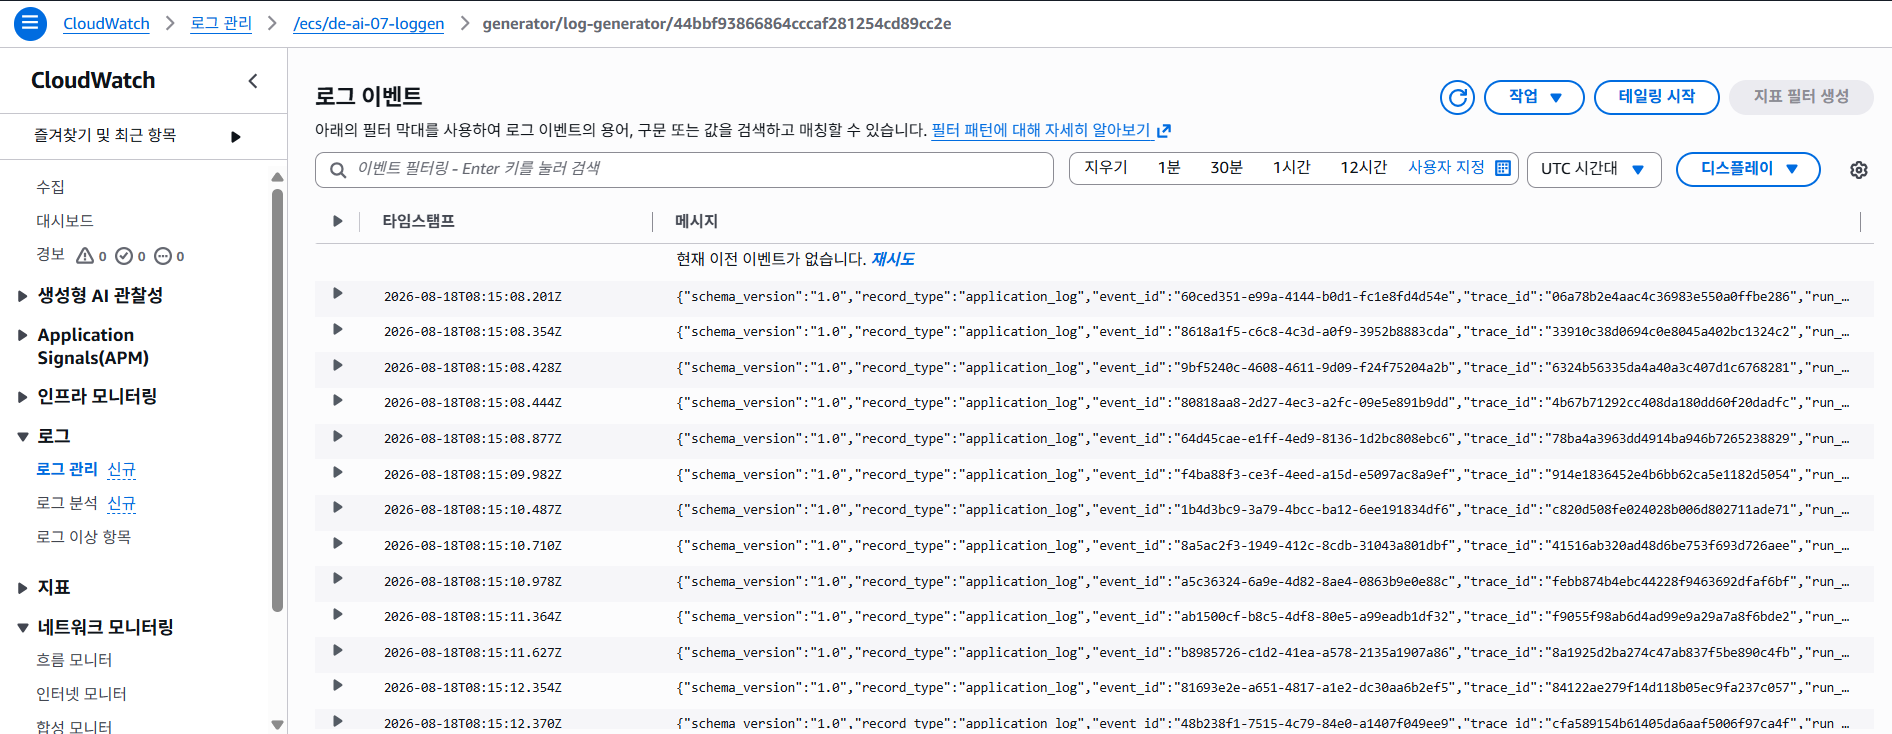
{"schema_version":"1.0","record_type":"application_log","event_id":"8a9f2...","trace_id":"0b12...","occurred_at":"2026-08-18T16:30:15.123+09:00","domain":"ecommerce","event_type":"order_created","service":{"name":"commerce-api","environment":"simulation"},"client":{"ip":"211.23.45.67","user_agent":"Mozilla/5.0 ..."},"request":{"method":"POST","path":"/api/orders","request_bytes":1240},"response":{"status_code":201,"latency_ms":287,"response_bytes":3590},"data":{"user_id":"usr_109283","order_id":"ord_f812...","total_amount":45000,"payment_method":"card"}}다음 단계는 어디로?
여러분은 이제 원하는 도메인의 대규모 로그 데이터를 확률 모델과 클라우드 서버리스 컨테이너를 이용해 마음껏 만들어낼 수 있는 강력한 데이터 소스 시뮬레이터를 손에 넣었습니다.
    Generator["🎯 우리가 만든 로그 생성기\n(AWS Fargate)"]
    CW["AWS CloudWatch"]
    S3[("AWS S3\n(Bronze Layer)")]
    Kinesis["AWS Kinesis / Kafka"]
    Spark["ETL Processing\n(Pandas / Polars / Spark)"]
    Athena["분석 & 시각화\n(Athena / Superset)"]

    Generator --> CW
    Generator --> S3
    Generator --> Kinesis
    S3 --> Spark
    Kinesis --> Spark
Spark --> Athena🔮 앞으로 연결해 볼 수 있는 멋진 프로젝트 아이디어
- Bronze -> Silver 정제 (ETL 실습): 우리가 의도적으로 주입한 5%의 오염 데이터(결측치, 깨진 JSON, 이상치)를
Pandas나PySpark로 걸러내는 클렌징 파이프라인 만들기 - 실시간 스트리밍 연동: 로그를
AWS Kinesis Data Streams나Apache Kafka로 전송하여 실시간 대시보드 만들기 - 서버리스 쿼리 엔진: S3에 적재된 로그를
AWS Athena와SQL로 집계하여 시간대별 매출 리포트 뽑아보기
'코딩 개발 > Date Engineer' 카테고리의 다른 글
| NumPy 공부 1부 — 데이터 분석을 시작하면 왜 NumPy부터 배우는 걸까? (0) | 2026.10.05 |
|---|---|
| [6편] CloudWatch에서 Kinesis + S3 Data Lake (Bronze Layer) 스트리밍 파이프라인 구축하기 (0) | 2026.10.02 |
| [4편] Terraform으로 100% 코드로 찍어내는 AWS 서버리스 인프라 (IaC) (0) | 2026.09.30 |
| [3편] 데이터 엔지니어의 숙명: 결측치와 이상치(오염 데이터) 의도적 주입 기법 (0) | 2026.09.29 |
| [2편] 통계학과 수학으로 진짜 트래픽 흉내내기 (포아송 분포 & 4대 도메인 모델링) (0) | 2026.09.28 |