안녕하세요! "Fargate와 Terraform으로 만드는 대용량 로그 생성기" 시리즈의 제3편입니다.
데이터 엔지니어링 분야에는 아주 유명한 격언이 하나 있습니다.
"Garbage In, Garbage Out (GIGO)"
(쓰레기가 들어가면, 결과물도 쓰레기가 나온다)
실제 현업 데이터 파이프라인에서 발생하는 장애의 80% 이상은 코드가 틀려서가 아니라, "예상치 못한 이상한 데이터(오염 데이터)"가 파이프라인에 밀고 들어오기 때문에 발생합니다.
이번 3편에서는 우리가 앞으로 진행할 데이터 정제(Data Cleaning / ETL) 실습을 위해, 9가지 현실적인 데이터 오염(Corruption)을 의도적으로 주입하는 방법을 알아보겠습니다!
1. 완벽하고 깨끗한 데이터는 왜 독(Poison)이 될까요?
만약 우리가 만든 로그 생성기가 오직 100% 정상적인 JSON 데이터만 만들어낸다면 어떻게 될까요?
- 파이프라인을 만들 때는 에러 없이 완벽하게 잘 돌아가는 것처럼 보입니다.
- 하지만 실제 상용 서비스에 배포하는 순간,
NullPointerException,JSONDecodeError,TypeMismatchException등이 터지며 파이프라인 전체가 멈춰버립니다.
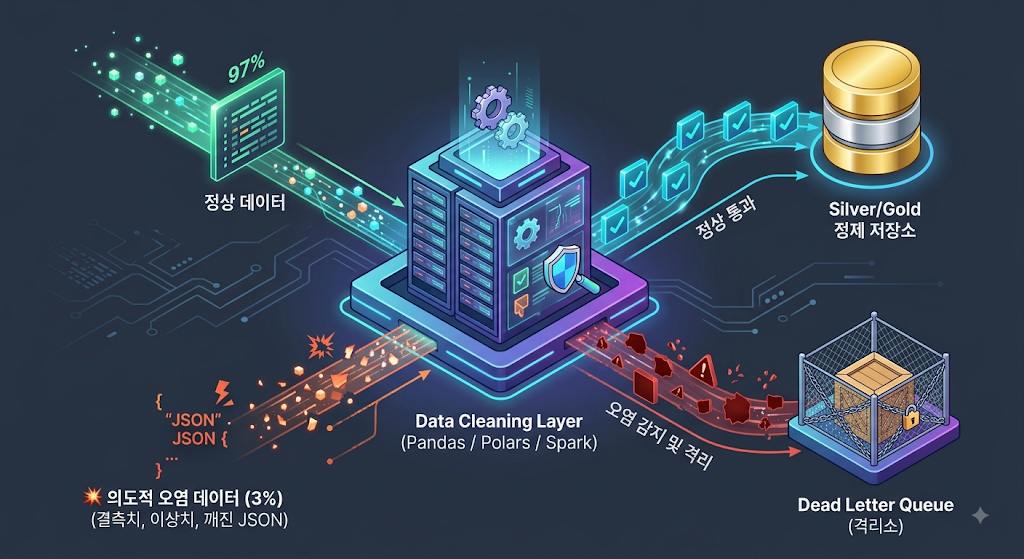
    A["정상 데이터 (97%)"] --> C["파이프라인 유입"]
    B["💥 의도적 오염 데이터 (3%)\n(결측치, 이상치, 깨진 JSON)"] --> C
    C --> D["Data Cleaning Layer\n(Pandas / Polars / Spark)"]
    D -->|정상 통과| E[("Silver/Gold\n정제 저장소")]
D -->|오염 감지 및 격리| F[("Dead Letter Queue\n(격리소)")]따라서 훌륭한 데이터 엔지니어가 되려면 오염된 데이터를 미리 만나보고, 이를 걸러내거나 정제하는 로직을 탄탄하게 작성해야 합니다.
2. 데이터 오염 엔진 완벽 해부: generator/app/corruption.py
우리는 CORRUPTION_RATE 환경변수(기본값 0.03, 즉 3%)를 통해 원하는 비율만큼 로그를 고장 낼 수 있도록 구현했습니다.
📄 오염 주입의 9가지 기술
STRUCTURED_CORRUPTIONS = [
    "missing_field",      # 1. 필수 필드 누락
    "null_required",      # 2. 필수 필드에 None(null) 주입
    "wrong_type",         # 3. 잘못된 자료형 주입
    "invalid_timestamp",  # 4. 파싱 불가능한 날짜 형식
    "numeric_outlier",    # 5. 극단적인 수치 이상치
    "invalid_enum",       # 6. 허용되지 않은 범주값
    "negative_latency",   # 7. 음수 지연시간
]이제 각 오염 유형이 어떻게 코드로 구현되었는지 하나씩 살펴보겠습니다.
🔍 1. 필수 필드 삭제 (missing_field)
candidates = [
    (result, "event_id"),
    (result, "occurred_at"),
    (result.get("response", {}), "status_code"),
]
parent, key = random.choice(candidates)
parent.pop(key, None)- 로그의 고유 식별자(
event_id)나 타임스탬프(occurred_at), 또는 응답코드(status_code) 필드 자체를 아예 지워버립니다. - 파이프라인에서
log["occurred_at"]처럼 바로 접근하는 코드가 있다면 즉시KeyError를 발생시키는 실무적인 오류입니다.
🔍 2. 필수 필드에 null 주입 (null_required)
target = random.choice(["event_type", "domain", "occurred_at"])
result[target] = None- 필드는 존재하지만 값이
null(None)인 경우입니다. 데이터베이스(DB)에NOT NULL제약조건이 걸려있다면 적재 실패를 유발합니다.
🔍 3. 잘못된 자료형 주입 (wrong_type)
result.setdefault("response", {})["latency_ms"] = random.choice(["fast", "120ms", [120]])- 숫자(Int)여야 할 응답시간 필드에
"120ms"나"fast"같은 문자열, 혹은[120]같은 배열을 집어넣습니다. - 스파크(Spark)나 파케이(Parquet)로 테이블을 생성할 때 스키마 불일치(Type Mismatch)를 일으킵니다.
🔍 4. 파싱할 수 없는 날짜/시간 (invalid_timestamp)
result["occurred_at"] = random.choice(["2026-99-99T25:61:00", "not-a-timestamp", "08/12/26 4PM"])99월 99일 25시 61분이나 비정형 문자열을 넣습니다. 날짜 파싱 라이브러리가 크래시 나지 않고 안전하게 처리(Fallback)하는지 검증할 수 있습니다.
🔍 5. 극단적인 수치 이상치 (numeric_outlier)
if result.get("domain") == "smartfactory":
    data["temperature_c"] = random.choice([9999.0, -273.5, 1.0e9])
elif result.get("domain") == "finance":
    data["amount"] = random.choice([-500000, 10**15])
elif result.get("domain") == "ecommerce":
data["quantity"] = random.choice([-2, 1000000])- 공장 센서 온도가 9,999°C이거나 절대영도 이하인 -273.5°C, 금융 결제 금액이 -50만 원이거나 1,000조 원, 상품 주문 수량이 -2개인 비즈니스적 이상치입니다.
- 머신러닝이나 통계 지표를 완전히 망가뜨릴 수 있으므로 데이터 엔지니어가 필터링해야 할 대표적 대상입니다.
🔍 6. 정의되지 않은 범주값 (invalid_enum)
if result.get("domain") == "smartfactory":
    data["state"] = "UNKNOWN_BROKEN_STATE"
elif result.get("domain") == "finance":
    data["channel"] = "carrier_pigeon" # 비둘기 전송?
elif result.get("domain") == "ecommerce":
data["currency"] = "KRWW"- 결제 통화가
KRW가 아닌KRWW, 은행 접근 채널이 모바일/웹이 아닌carrier_pigeon(전서구/비둘기)으로 들어옵니다.
🔍 7. 음수 응답시간 (negative_latency)
result.setdefault("response", {})["latency_ms"] = -random.randint(1, 5000)- 타임스탬프 계산 오류 등으로 서버 응답시간이 -1500ms로 찍히는 논리적 오류 데이터입니다.
🔍 8. 중복 레코드 (duplicate)
# main.py에서 직전 정상 이벤트를 기억해 두었다가 복제하여 전송
duplicate = copy.deepcopy(previous_event)- 네트워크 재전송이나 분산 시스템의
At-least-once특성으로 인해 동일한event_id를 가진 로그가 2번 들어오는 현상입니다. 중복 제거(Deduplication) 로직 검증에 필수적입니다.
🔍 9. 문법이 깨진 JSON (malformed_json)
# output.py
if malformed_json:
    cut = max(1, len(line) - max(1, min(12, len(line) // 10)))
line = line[:cut] # JSON 문자열 뒷부분을 가위로 싹둑 자름!{"event_id": "8a9f", "domain": "ecomm처럼 네트워크 단절로 중간에 잘려버린 JSON 문자열입니다.json.loads()가 에러를 뿜게 만들어 파이프라인의 에러 핸들링을 테스트합니다.
3. 원본 보호와 정답지(Ground Truth) 라벨링
💡 깊은 복사(copy.deepcopy)의 중요성
파이썬에서 딕셔너리를 수정할 때 copy.deepcopy()를 쓰지 않으면, 중복 이벤트를 만들거나 원본 데이터를 조작할 때 메모리 상의 이전 이벤트까지 함께 오염되는 버그가 발생합니다. 깊은 복사를 통해 안전하게 독립된 사본을 만듭니다.
💡 _simulation 라벨 (채점표 기능)
환경변수 INCLUDE_CORRUPTION_LABEL=true로 켜면 아래와 같은 메타데이터가 로그에 함께 기록됩니다.
{
  "event_id": "...",
  "_simulation": {
    "is_corrupted": true,
    "corruption_type": "numeric_outlier"
  }
}- 이 라벨은 우리가 나중에 데이터 클렌징 알고리즘을 작성했을 때, "내가 작성한 코드가 실제로 오염 데이터를 100% 정확하게 잡아냈는지" 채점(Ground Truth)하는 용도로 활용할 수 있습니다!
🎯 3편 요약 및 다음 편 예고
- 현업 데이터 파이프라인을 견고하게 만들기 위해서는 의도적인 오염 데이터 시뮬레이션이 필수적입니다.
- 결측치, 잘못된 타입, 이상치, 중복, 깨진 JSON 등 9가지 실무형 오염 기법을 구현했습니다.
- 깊은 복사와 정답 라벨링을 통해 안전하고 검증 가능한 데이터셋을 완성했습니다.
이제 파이썬 코드는 완벽하게 준비되었습니다!
다음 [4편]에서는 이 코드를 클라우드에 띄우기 위해, Terraform을 이용해 AWS VPC, ECR, ECS Fargate 등 서버리스 인프라를 코드로 구축(IaC)해 보겠습니다.
'코딩 개발 > Date Engineer' 카테고리의 다른 글
| [5편] Docker 컨테이너 빌드부터 AWS ECS 1-Click 대량 실행 파이프라인까지 (0) | 2026.10.01 |
|---|---|
| [4편] Terraform으로 100% 코드로 찍어내는 AWS 서버리스 인프라 (IaC) (0) | 2026.09.30 |
| [2편] 통계학과 수학으로 진짜 트래픽 흉내내기 (포아송 분포 & 4대 도메인 모델링) (0) | 2026.09.28 |
| [1편] 데이터 엔지니어링의 시작: 왜 '현실적인 로그 생성기'가 필요할까? (아키텍처 & 스키마 설계) (0) | 2026.09.23 |
| [DE 8편] 이벤트 기반 데이터 파이프라인: S3 Producer/Consumer 패턴 & S3KeySensor를 활용한 데이터 감지 및 처리 (1) | 2026.09.22 |