https://github.com/hosose/LOG_GEN
GitHub - hosose/LOG_GEN
Contribute to hosose/LOG_GEN development by creating an account on GitHub.
github.com
이 시리즈에서는 AWS Fargate와 Terraform(IaC)을 활용하여 실무 수준의 대용량 로그 생성기 & 트래픽 시뮬레이터를 처음부터 끝까지 직접 구축해 봅니다.
첫 번째 시간인 1편에서는 "도대체 로그 생성기가 왜 필요한지"와 "실무에서 통하는 표준 로그 데이터는 어떻게 설계해야 하는지"를 쌩초보의 눈높이에 맞춰 하나씩 차근차근 알아보겠습니다!
1. 데이터 엔지니어에게 '로그 생성기'가 왜 필요할까요?
초보자가 가장 많이 하는 고민
"카프카(Kafka)나 스파크(Spark), 데이터 파이프라인 실습을 해보고 싶은데... 분석할 데이터가 없어요!"
"인터넷에서 다운받은 CSV 파일 하나로 파이프라인을 돌리니까 실시간 스트리밍 느낌이 전혀 안 나요."
데이터 엔지니어링 실무에서는 초당 수천~수만 건씩 쏟아지는 웹/앱 서버의 실시간 로그를 수집하고 정제합니다.
하지만 학습이나 테스트 단계에서는 실제 상용 서비스의 데이터를 가져다 쓸 수 없습니다. (개인정보 보호법과 보안 문제 때문이죠!)
그래서 필요한 것이 바로 현실과 똑같이 동작하는 가상 데이터 소스 시뮬레이터(Log Generator)입니다.
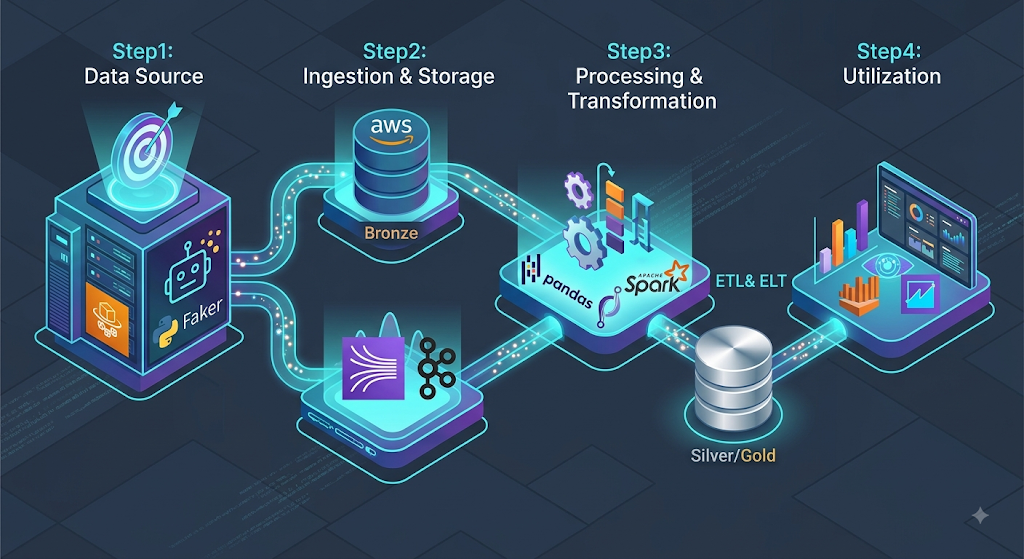
우리가 만들 로그 생성기는 위 그림의 가장 첫 단추(Data Source) 역할을 합니다.
단순히 가짜 텍스트를 마구 찍어내는 것이 아니라, 진짜 서비스처럼 시간대별 피크 타임, 네트워크 지연, 가끔 터지는 서버 에러 및 데이터 오염까지 완벽히 시뮬레이션합니다.
2. 전체 프로젝트 디렉토리 구조 파악하기
우리가 다루게 될 프로젝트의 폴더 구조는 아래처럼 아주 깔끔하게 정리되어 있습니다.
LOG_GEN/
├── generator/            # [파이썬 애플리케이션] 로그를 생성하는 핵심 로직
│   ├── app/
│   │   ├── domains/      # 4대 비즈니스 도메인 (이커머스, 금융, 공장, 게임)
│   │   ├── common.py     # 공통 로그 포맷, HTTP 상태코드, 응답시간 생성
│   │   ├── config.py     # 환경변수 로드 및 유효성 검증
│   │   ├── corruption.py # 의도적인 이상치/오염 데이터 주입 로직
│   │   ├── output.py     # JSONL 표준 출력 및 파일 저장 처리
│   │   ├── traffic.py    # 수학/통계 기반 트래픽 속도 제어
│   │   └── main.py       # 애플리케이션 메인 실행 진입점
│   ├── Dockerfile        # 컨테이너 이미지 빌드 명세서
│   └── requirements.txt  # 파이썬 의존성 (Faker 등)
├── infra/                # [테라폼 IaC] AWS 인프라(VPC, ECR, ECS Fargate) 코드
├── scripts/              # [자동화 스크립트] 1-Click 빌드, 로컬 테스트 및 AWS 실행
└── readme.MD # 전체 프로젝트 가이드 문서3. 실무형 표준 로그 스키마(Schema) 설계
실제 IT 기업(쿠팡, 토스, 넷플릭스 등)에서 사용하는 로그는 어떤 모습일까요?
우리는 전 세계 표준에 맞춘 JSON 포맷의 공통 스키마를 정의했습니다.
📄 표준 로그 데이터 예시
{
  "schema_version": "1.0",
  "record_type": "application_log",
  "event_id": "8a9f2341-b45c-4d89-91a2-ec7f12345678",
  "trace_id": "e93ab87102c94381a81234567890abcd",
  "run_id": "manual-run-01",
  "occurred_at": "2026-08-18T16:30:11.123+09:00",
  "generated_at_utc": "2026-08-18T07:30:11.123+00:00",
  "domain": "ecommerce",
  "event_type": "order_created",
  "service": {
    "name": "commerce-api",
    "environment": "simulation",
    "instance_id": "sim-07"
  },
  "client": {
    "ip": "211.23.45.67",
    "user_agent": "Mozilla/5.0 Chrome/151.0 Windows/10",
    "device_id": "dev_9821af3e"
  },
  "request": {
    "method": "POST",
    "path": "/api/orders",
    "request_bytes": 1240
  },
  "response": {
    "status_code": 201,
    "latency_ms": 287,
    "response_bytes": 3590
  },
  "data": {
    "user_id": "usr_109283",
    "order_id": "ord_f8123984",
    "total_amount": 45000,
    "payment_method": "card"
  }
}🔍 핵심 필드 해설 (초보자 필수 지식!)
event_idvstrace_id:event_id: 이 로그 한 건만을 위한 고유 번호 (주민번호 같은 식별자)trace_id: 분산 추적(Distributed Tracing)용 ID입니다. 사용자가 버튼 하나를 눌렀을 때 웹서버 → 주문서버 → 결제서버로 요청이 이어지더라도 모두 동일한trace_id를 공유하므로, 장애 발생 시 원인을 추적할 수 있습니다.
occurred_at(KST) vsgenerated_at_utc(UTC):- 한국 로컬 시간(
+09:00)과 전 세계 공통 표준시인UTC를 둘 다 기록합니다. 글로벌 서비스나 데이터 레이크에서는 표준시 기준 파티셔닝이 필수적이기 때문입니다.
- 한국 로컬 시간(
request&response:- HTTP 메서드(
GET,POST), 엔드포인트 경로, 상태 코드(200,201,500), 그리고 API 처리 지연시간(latency_ms)을 기록합니다.
- HTTP 메서드(
data:- 이커머스, 금융, 스마트팩토리, 게임 등 각 비즈니스 도메인에 특화된 고유 데이터가 담기는 공간입니다.
💡 Tip: ISO 8601 날짜 형식이란?
2026-08-18T16:30:11.123+09:00처럼T로 날짜와 시간을 구분하고 맨 뒤에 타임존 오프셋(+09:00)을 붙이는 전 세계 국제 표준 표기법입니다. 문자열 그대로 정렬(Sort)해도 시간 순서가 정확히 맞아 데이터 엔지니어링에서 가장 선호됩니다.
4. 핵심 코드 한 줄씩 뜯어보기
① generator/app/common.py (공통 모듈)
이 파일은 모든 도메인이 공통으로 사용하는 기본 뼈대를 만듭니다.
# 로그정규분포(Lognormal Distribution)를 이용한 현실적인 지연시간 생성
def latency_ms(median: float, sigma: float = 0.45, minimum: int = 2, maximum: int = 10000) -> int:
    value = random.lognormvariate(math.log(max(median, 1)), sigma)
return int(max(minimum, min(value, maximum)))- 대부분의 API는 50~100ms 안팎으로 빠르지만, 가끔 DB 락이나 네트워크 지연으로 수 초씩 걸리는 긴 꼬리(Long-tail) 현상이 발생합니다.
random.lognormvariate수학 함수를 써서 이를 완벽히 재현했습니다.
# 성공, 클라이언트 오류(4xx), 서버 오류(5xx)를 실무 비율로 생성
def http_status(method: str, success: float = 0.965, client_error: float = 0.027) -> int:
    r = random.random()
    if r < success:
        return 200 if method == "GET" else random.choices([200, 201, 204], weights=[50, 35, 15])[0]
    if r < success + client_error:
        return random.choices([400, 401, 403, 404, 429], weights=[20, 15, 15, 30, 20])[0]
return random.choices([500, 502, 503, 504], weights=[50, 20, 20, 10])[0]- 실제 서비스처럼 약 96.5%는 정상 응답(
2xx), 2.7%는 잘못된 요청(4xx), 그리고 약 0.8%의 서버 장애(5xx)를 통계적으로 발생시킵니다.
② generator/app/config.py (환경변수 설정 관리)
컨테이너 환경에서는 모든 설정값을 환경변수(Environment Variables)로 주입받습니다.
@dataclass(frozen=True)
class Settings:
    domain: str
    duration_seconds: int
    max_events: int
    base_rps: float
    time_scale: float
    corruption_rate: float
    # ...

    @classmethod
    def from_env(cls) -> "Settings":
        domain = _env("DOMAIN", "ecommerce").lower()
        if domain not in VALID_DOMAINS:
            raise ValueError(f"DOMAIN must be one of: {', '.join(sorted(VALID_DOMAINS))}")
# ...@dataclass(frozen=True): 한 번 로드된 설정값이 코드 실행 도중 실수로 바뀌지 않도록 불변(Immutable) 객체로 안전하게 잠급니다.from_env(): 환경변수를 읽으면서 잘못된 값(음수 시간, 지원하지 않는 도메인 등)이 들어오면 실행 전에 즉시 오류를 내어 시스템 장애를 방지합니다.
💡 Tip: 12-Factor App 원칙
클라우드 네이티브 애플리케이션 설계의 핵심 원칙 중 하나는 "설정(Config)을 코드에서 엄격히 분리하여 환경변수에 저장하라"입니다. 이렇게 설계하면 도커 이미지를 다시 빌드하지 않고도 환경변수만 바꿔서 이커머스용, 금융용으로 자유자재로 실행할 수 있습니다!
🎯 1편 요약 및 다음 편 예고
- 데이터 파이프라인의 완성도를 높이려면 실제 서비스와 유사한 고품질 시뮬레이터가 반드시 필요합니다.
- 우리는 분산 추적(
trace_id), 표준 타임스탬프(ISO 8601), 현실적인 HTTP 상태코드 및 지연시간을 갖춘 표준 로그 스키마를 설계했습니다. - 설정값은 불변 데이터클래스와 환경변수를 통해 유연하고 안전하게 관리합니다.
다음 [2편]에서는 "통계학과 수학으로 진짜 트래픽 흉내내기"를 주제로, 포아송 분포와 시간대별 가중치, 그리고 4대 비즈니스 도메인의 세부 모델링을 자세히 살펴보겠습니다.