https://github.com/hosose/DE/tree/aws
GitHub - hosose/DE at aws
Contribute to hosose/DE development by creating an account on GitHub.
github.com
끝인 줄 알았지만 연재는 계속 되었답니다.... ㅋㅋㅋㅋ
다시 달려보시죠 아직 할게 많았군요.
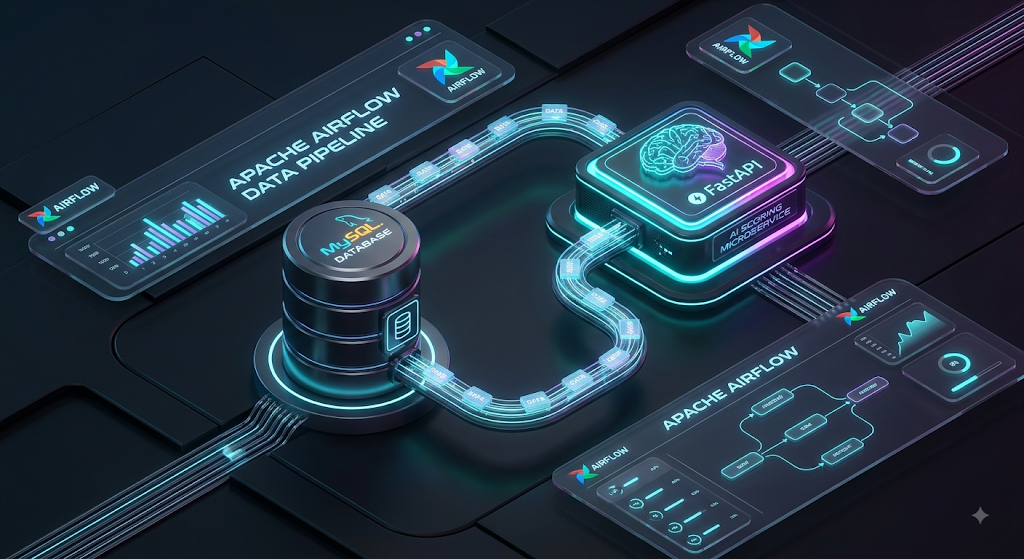
1. 실무 비즈니스 시나리오: 신규 고객 자동 AI 신용평가 시스템
핀테크 및 금융 도메인에서는 매일 수많은 신규 고객이 회원가입을 하거나 기존 고객의 소득/대출 정보가 갱신됩니다.
하지만 실시간으로 모든 AI/ML 모델 추론을 웹 서버 트래픽 안에서 수행하면 서버 부하가 급증하고 응답 지연이 발생할 수 있습니다.
따라서 실무에서는 매일 자정(배치 주기)에 다음과 같은 자동화 파이프라인을 운영합니다:
- DB 조회 (Extract): MySQL 데이터베이스에서 아직 신용평가를 받지 않은(
credit_score IS NULL) 신규/갱신 고객들을 일괄 추출합니다. - AI 서빙 API 호출 (Transform/Inference): 추출한 고객 목록을 FastAPI 기반 AI 신용평가 마이크로서비스로 전송하여 신용점수와 신용등급을 일괄 추론합니다.
- DB 일괄 갱신 (Load/Update): 추론된 점수(
credit_score)와 등급(grade)을 MySQL 데이터베이스에 벌크(Bulk) 업데이트합니다.
flowchart LR
    A[1. t1: 더미 고객 데이터 생성<br/>UUID 기반 50명 삽입] --> B[2. t2: 미평가 고객 추출<br/>MySqlHook.get_pandas_df]
    B -->|XCom: 미평가 고객 목록| C[3. t3: FastAPI 서빙 호출<br/>POST /predict AI 추론]
C -->|XCom: 평가 완료 결과| D[4. t4: 고객 DB 일괄 갱신<br/>executemany UPDATE]2. FastAPI AI 신용평가 마이크로서비스 (api_server/main.py)
먼저 고객의 소득(income)과 대출금액(loan_amt)을 입력받아 신용점수와 등급을 산출해주는 FastAPI REST API 서버를 구성합니다.
소스 코드 위치: api_server/main.py
from fastapi import FastAPI
from pydantic import BaseModel
from typing import List
import random

app = FastAPI()

# 1. 요청 데이터 스키마 (Pydantic 모델)
class ReqData(BaseModel):
    user_id: str   # 사용자 고유 식별자
    income: int    # 연간 소득
    loan_amt: int  # 현재 보유 대출액

# 2. 응답 데이터 스키마
class ResData(BaseModel):
    user_id: str
    credit_score: int  # 산출된 신용점수 (0 ~ 990점)
    grade: str         # 신용등급 (A, B, C)

@app.get("/")
def home():
    return {"status": "AI 신용평가 서비스 API 정상 가동 중"}

@app.post("/predict", response_model=List[ResData])
def predict(users: List[ReqData]):
    """
    여러 고객 데이터를 리스트로 받아 일괄 신용평가를 수행합니다.
    """
    results = []
    for user in users:
        # 가상 신용평가 알고리즘 (소득 반영 가중치 + 신용 위험 난수)
        weight = (user.income // 1000) * 10
        credit_score = min(random.randint(300, 600) + weight, 990)
        grade = "A" if credit_score >= 800 else "B" if credit_score >= 600 else "C"

        results.append({
            "user_id": user.user_id,
            "credit_score": credit_score,
            "grade": grade
        })
return results📌 FastAPI의 장점:
Pydantic을 통한 강력한 입력 데이터 유효성 검증(Validation) 및 직렬화/역직렬화 자동화- 비동기 고성능 지원과
/docs를 통한 Swagger UI 자동 생성
3. Airflow 파이프라인 전체 구현 (dags/07_api_server_used.py)
소스 코드 위치: dags/07_api_server_used.py
from airflow import DAG
from airflow.operators.python import PythonOperator
from airflow.providers.mysql.hooks.mysql import MySqlHook
from datetime import datetime, timedelta
from contextlib import closing
import logging
import pendulum
import random
import requests
import uuid

# 1. 전역 설정
KST = pendulum.timezone("Asia/Seoul")
# Docker Compose 네트워크 내부에서는 서비스 명칭(ai-api-server)으로 직접 통신합니다.
API_URL = "http://ai-api-server:8000/predict"

# Task 1: 테스트용 미평가 고객 더미 데이터 생성
def _create_dummy_data(**kwargs):
    hooks = MySqlHook(mysql_conn_id="mysql_default")
    with closing(hooks.get_conn()) as conn:
        with closing(conn.cursor()) as cursor:
            # 고객 테이블 생성 (DDL)
            cursor.execute("""
                CREATE TABLE IF NOT EXISTS customers (
                    user_id VARCHAR(50) PRIMARY KEY,
                    income INT DEFAULT NULL,
                    loan_amt INT DEFAULT NULL,
                    credit_score INT DEFAULT NULL,
                    grade VARCHAR(10) DEFAULT NULL,
                    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
                );
            """)
            # 신규 고객 50명 더미 생성 (credit_score, grade는 NULL 상태)
            sql = "INSERT INTO customers (user_id, income, loan_amt) VALUES (%s, %s, %s)"
            params = [
                (f"u-{uuid.uuid4().hex[:12]}", random.randint(3000, 10000), random.randint(1000, 5000))
                for _ in range(50)
            ]
            cursor.executemany(sql, params)
            conn.commit()
    logging.info("더미 고객 데이터 50건 생성 및 적재 완료")

# Task 2: DB에서 신용평가 대상(credit_score IS NULL) 조회
def _extract_user_data(**kwargs):
    hooks = MySqlHook(mysql_conn_id="mysql_default")

    # get_pandas_df()를 활용하여 SQL 쿼리 결과를 DataFrame으로 즉시 획득
    df = hooks.get_pandas_df("""
        SELECT user_id, income, loan_amt
        FROM customers
        WHERE credit_score IS NULL;
    """)

    if df.empty:
        logging.info("평가 대상 고객이 없습니다.")
        return []

    logging.info(f"신용평가 대상: 총 {df.shape[0]}명")
    # DataFrame -> List[dict] 변환 후 XCom 반환
    return df.to_dict(orient="records")

# Task 3: FastAPI AI 서빙 서버 호출 및 예측 결과 획득
def _api_service_call(**kwargs):
    ti = kwargs["ti"]
    target_user_data = ti.xcom_pull(task_ids="task_extract_data")

    if not target_user_data:
        logging.info("전송할 고객 데이터가 비어 있습니다.")
        return []

    try:
        # FastAPI 마이크로서비스로 POST JSON 요청
        response = requests.post(API_URL, json=target_user_data, timeout=30)
        response.raise_for_status()

        results = response.json()
        logging.info(f"AI 신용평가 완료: {len(results)}건 수신 완료")
        return results
    except Exception as e:
        logging.error(f"FastAPI 통신 중 오류 발생: {e}")
        raise

# Task 4: 평가 완료 결과를 MySQL에 벌크 업데이트
def _load_user_credit(**kwargs):
    ti = kwargs["ti"]
    evaluated_users = ti.xcom_pull(task_ids="task_api_service_data")

    if not evaluated_users:
        logging.info("업데이트할 신용평가 결과가 없습니다.")
        return

    hooks = MySqlHook(mysql_conn_id="mysql_default")
    with closing(hooks.get_conn()) as conn:
        with closing(conn.cursor()) as cursor:
            sql = """
                UPDATE customers
                SET credit_score = %s, grade = %s
                WHERE user_id = %s
            """
            params = [
                (data["credit_score"], data["grade"], data["user_id"])
                for data in evaluated_users
            ]
            cursor.executemany(sql, params)
            conn.commit()
    logging.info(f"MySQL 고객 테이블 {len(evaluated_users)}건 업데이트 완료")

# 2. DAG 정의
with DAG(
    dag_id="07_api_server_used",
    description="특정 주기 단위로 고객 신용 정보 업데이트 파이프라인",
    default_args={
        "owner": "aic-de1-admin",
        "retries": 1,
        "retry_delay": timedelta(minutes=1),
    },
    schedule_interval="@daily",
    start_date=pendulum.datetime(2026, 6, 29, tz=KST),
    catchup=False,
    tags=["etl", "api", "mysql", "fastapi"]
) as dag:

    t1 = PythonOperator(task_id="task_create_dummy_data", python_callable=_create_dummy_data)
    t2 = PythonOperator(task_id="task_extract_data", python_callable=_extract_user_data)
    t3 = PythonOperator(task_id="task_api_service_data", python_callable=_api_service_call)
    t4 = PythonOperator(task_id="task_load_users_data", python_callable=_load_user_credit)

    # 파이프라인 순서 연결
t1 >> t2 >> t3 >> t44. 핵심 기술 포인트 분석
1) Docker 내부 DNS 네트워크 통신
Airflow 컨테이너에서 로컬 머신의 FastAPI 서버로 접근할 때 localhost:8000을 쓰면 컨테이너 자기 자신을 가리켜 연결 오류(Connection Refused)가 납니다.
docker-compose.yaml에 등록된 서비스명인 http://ai-api-server:8000을 엔드포인트로 지정해야 도커 내장 DNS가 자동으로 IP를 라우팅해 줍니다.
2) MySqlHook.get_pandas_df()의 편리함
MySqlHook의 get_pandas_df() 메서드를 사용하면 복잡한 cursor.fetchall() 및 컬럼 매핑 과정 없이 즉시 pandas.DataFrame 객체로 변환할 수 있어 데이터 정제 및 가공 속도가 획기적으로 향상됩니다.
3) contextlib.closing을 통한 리소스 누수 방지
데이터베이스 커넥션과 커서는 예외가 발생하더라도 반드시 반환(close)되어야 커넥션 풀 고갈을 방지할 수 있습니다. with closing(...) 블록을 사용하면 파이썬이 종료 시 자동으로 자원을 안전하게 해제합니다.
5. 데이터 엔지니어 실무 현업 꿀팁 (Tip)
1. 대용량 데이터 처리 시 XCom 메모리 한계 극복 (Chunking & S3 Staging)
본 예제에서는 수십 건의 데이터를 XCom으로 주고받았지만, 실무에서 수십만~수백만 건의 고객 데이터를 XCom에 올리면 Airflow 메타데이터 DB(PostgreSQL)의 용량이 폭증하고 스케줄러가 다운됩니다.
- 해결책 1: 수만 건 단위로
Chunking(분할)하여 배치 API를 호출합니다.- 해결책 2: 추출한 데이터를 S3/GCS 임시 버킷에 Parquet/JSONL 파일로 저장하고, XCom으로는 오직
s3://bucket/path/data.parquet경로 문자열만 전달하는 'Claim Check Pattern'을 적용하세요.
[!TIP]
2. REST API 호출 시 타임아웃과 재시도(Retry & Backoff) 전략
외부 AI 서빙 서버는 순간적인 트래픽 폭주나 GPU 연산 지연으로 응답이 늦어질 수 있습니다.
requests.post(url, timeout=(5, 60))처럼 (Connection Timeout, Read Timeout)을 명시하세요.urllib3.util.Retry또는 Python의tenacity라이브러리를 사용하여 일시적인 네트워크 오류 시 Exponential Backoff(지수 백오프) 재시도를 구성하는 것이 실무 표준입니다.
[!TIP]
3. Bulk Update 최적화:
executemanyvsINSERT ... ON DUPLICATE KEY UPDATEMySQL에서 대량의 Row를 업데이트할 때 단순
executemany UPDATE는 레코드 수만큼의 개별 UPDATE 쿼리를 묶어서 실행하므로 속도가 저하될 수 있습니다.
- 성능이 매우 중요한 초대용량 환경에서는 임시 테이블(Temporary Table)에 벌크 INSERT 후
JOIN UPDATE를 수행하거나,INSERT INTO ... VALUES (...) ON DUPLICATE KEY UPDATE구문을 활용하면 처리 속도를 5~10배 이상 향상시킬 수 있습니다.
6. 6편 요약 및 다음 편 예고
이번 6편에서는 Airflow 파이프라인에서 MySQL의 미평가 고객 데이터를 실시간 추출(Extract)하고, FastAPI AI 신용평가 마이크로서비스를 호출(Transform/Inference)한 뒤, 결과를 다시 MySQL 데이터베이스에 벌크 갱신(Load/Update)하는 E2E 배치 워크플로우를 구현해보았습니다.
다음 7편에서는 클라우드 데이터 엔지니어링의 핵심인 AWS S3 데이터 레이크를 다룹니다. Terraform(IaC)을 이용한 보안 모범 버킷 프로비저닝부터 LocalFilesystemToS3Operator 및 S3Hook을 통한 S3 데이터 적재 및 무결성 검증을 실습해보겠습니다.