안녕하세요! 데이터 엔지니어링 파이프라인 시리즈의 마지막 4편입니다.
[1편]부터 [3편]까지 데이터 발생, 수집, S3 데이터 레이크 구축, 그리고 Airflow 기반 배치 정제 파이프라인을 알아보았습니다.
마지막 4편에서는 초단위 지연 시간(Latency)으로 데이터를 감지하고 처리하는 실시간 스트리밍 파이프라인과, 현업에서 가장 많이 논의되는 ETL vs ELT 아키텍처 패턴을 비교 정리해 보겠습니다.
1. 실시간 스트리밍 파이프라인 (Real-time Streaming Pipeline)
배치(Batch) 처리가 일정 주기(시간/일 단위)로 데이터를 처리한다면, 스트리밍(Streaming) 처리는 데이터가 발생하는 순간 즉시(초/밀리초 단위) 연산하여 알림을 보내거나 대시보드에 반영하는 방식입니다.
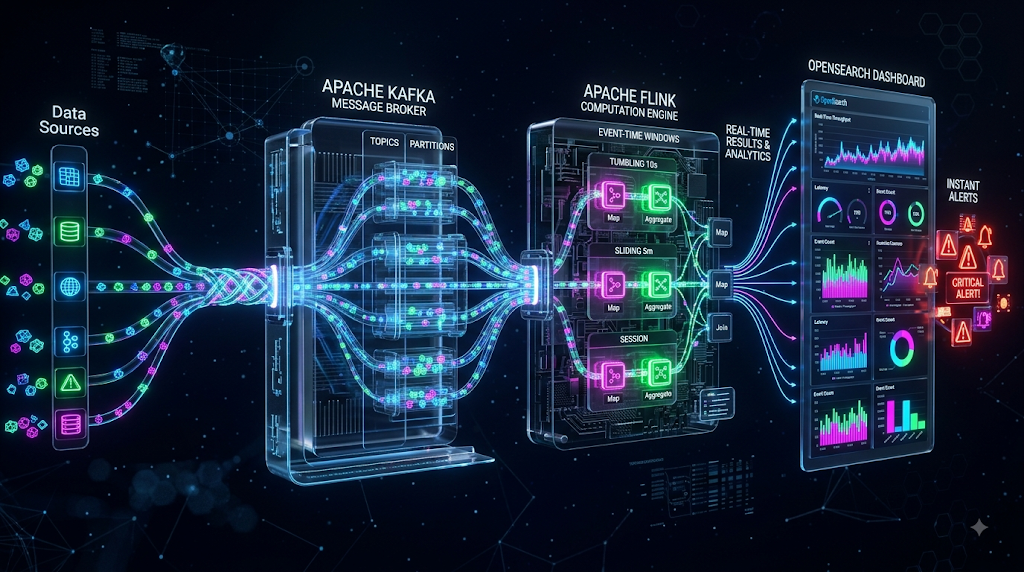
┌────────────────────────────────────────────────────────────────────────┐
│                    03. REAL-TIME STREAMING PIPELINE                    │
└────────────────────────────────────────────────────────────────────────┘

                           FastAPI / 로그 발생기
                                     │
               ┌─────────────────────┴─────────────────────┐
               ▼                                           ▼
       Kafka / Amazon MSK                        Kinesis Data Streams
               │                                           │
               └─────────────────────┬─────────────────────┘
                                     ▼
                             Apache Flink / Spark
                              (Streaming Engine)
                                     │
                         ┌───────────┴───────────┐
                         │ Window / Aggregations │
                         │ Filter / Detection    │
                         └───────────┬───────────┘
                                     │
               ┌─────────────────────┼─────────────────────┐
               ▼                     ▼                     ▼
       OpenSearch (ELK)          S3 Silver            Real-time Alert
(실시간 관제/대시보드) (실시간 정제 적재) (Slack/SNS 이상 감지)💡 주요 유스케이스 (Use Cases)
- 금융 시스템: 이상 거래 감지 (FDS - Fraud Detection System)
- 제조/IoT: 공장 설비의 실시간 온도/진동 이상 수치 감지
- 커머스/게임: 실시간 실시간 주문량 타임세일 모니터링, 실시간 동시 접속자 수 집계
💡 DE Tech Tip #1: Event Time vs Processing Time과 Watermark
- 실시간 스트리밍 시 네트워크 지연으로 인해 "데이터가 실제로 발생한 시각(Event Time)"과 "파이프라인에 도착한 시각(Processing Time)" 사이에 차이가 생깁니다.
- Apache Flink나 Spark Streaming을 사용할 때는 반드시 Event Time 기준의 Watermark(워터마크)를 설정해야 늦게 도착한 데이터(Late Data)를 누락 없이 윈도우 연산(Tumbling/Sliding Window)에 정확히 반영할 수 있습니다.
2. ETL vs ELT 아키텍처 완벽 비교
데이터 변환(Transform)이 어디서(Where) 일어나느냐에 따라 파이프라인 아키텍처는 ETL과 ELT로 나뉩니다.
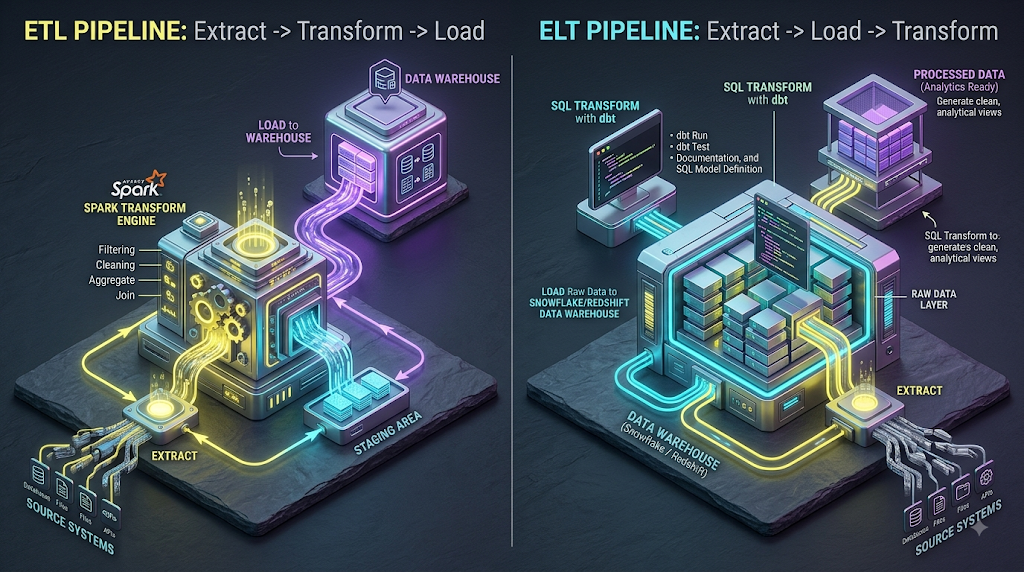
[ETL Pipeline]
Source ──▶ Extract ──▶ Transform (Spark/Glue) ──▶ Load (Data Warehouse)

[ELT Pipeline]
Source ──▶ Extract ──▶ Load (Data Warehouse/S3) ──▶ Transform (SQL/dbt)1) ETL (Extract ➡️ Transform ➡️ Load)
데이터를 중앙 저장소나 DW에 쌓기 전에 가공 엔진(Spark, Glue, Python)에서 먼저 정제하고 로드합니다.
- 장점:
- DW에 들어가기 전 개인정보(PII) 마스킹 및 비정형 데이터 정제 수행 가능.
- 불필요한 데이터를 미리 제거하므로 스토리지 용량 절감.
- 단점:
- 데이터 변환 로직이 변경되면 파이프라인 코드(Python/Scala)를 수정하고 재배포해야 함.
2) ELT (Extract ➡️ Load ➡️ Transform)
Raw 데이터 그대로 대용량 클라우드 데이터 웨어하우스(Redshift, Snowflake, BigQuery)나 S3에 먼저 저장(Load)한 뒤, DW의 막강한 SQL 컴퓨팅 파워를 이용해 변환(Transform)합니다.
- 장점:
- Modern Data Stack (MDS)의 핵심 패턴으로, dbt(data build tool) 등의 SQL 기반 변환 도구 활용 가능.
- 원본 데이터가 DW에 보존되므로 데이터 분석가(DA)가 자유롭게 SQL로 새로운 데이터마트 생성 가능.
- 단점:
- Raw 데이터까지 DW에 전부 적재되므로 DW 스토리지 및 컴퓨팅 비용이 상승할 수 있음.
💡 DE Tech Tip #2: ETL vs ELT 선택 기준 요약
- ETL 추천: 민감 정보(주민번호, 계좌번호) 보안 규제가 엄격한 금융/의료 시스템, 비정형 로그/이미지 데이터 전처리.
- ELT 추천: 빠른 분석 데이터마트 구축이 필요한 스타트업/커머스, Snowflake/Redshift 등 고성능 클라우드 DW를 도입한 환경.
- EtLT (하이브리드): 최근 실무에서는 민감 정보 제거 및 포맷 변환(Parquet)만 1차로 수행(ETL)한 후, DW에 넣고 비즈니스 집계 SQL을 돌리는(ELT) EtLT 형태가 가장 많이 활용됩니다.
3. 파이프라인 전체를 완성하는 2가지 축: Orchestration & Observability
데이터 파이프라인이 안정적으로 작동하기 위해서는 단순 데이터 흐름 외에 전체 관제 시스템이 필수적입니다.
────────────────────────────────────────────────────────────
전체 파이프라인을 지탱하는 기반 기술

1. Orchestration  : Apache Airflow (배치 작업 스케줄링, 실패 시 Retry)
2. Observability  : Grafana + Prometheus (인프라 메트릭)
                    OpenSearch / Kibana (로그 모니터링 & 대시보드)
────────────────────────────────────────────────────────────🏁 시리즈를 마치며 (전체 총평)
지난 1편부터 4편에 걸쳐 데이터 엔지니어링의 전체 생명주기를 완주했습니다!
- 1편: 데이터 라이프사이클 8단계 & k6 + FastAPI 더미 데이터 제너레이터
- 2편: CloudWatch + Data Firehose ➡️ S3 Bronze 파티셔닝 & Athena 조회의 Ingestion 파이프라인
- 3편: Airflow 스케줄링 & 데이터 규모별 엔진(Pandas vs Polars vs PySpark)의 Batch 파이프라인
- 4편: Kafka/Flink 실시간 스트리밍 파이프라인 & ETL vs ELT 패턴 및 Observability
데이터 파이프라인에는 단 하나의 정답이 존재하지 않습니다. 데이터의 성격(실시간 vs 배치), 데이터의 규모(GB vs TB), 팀의 인프라 예약 예산에 맞게 가장 적합한 도구와 아키텍처 패턴을 선택하는 것이 훌륭한 데이터 엔지니어의 핵심 역량입니다.
그동안 시리즈를 읽어주셔서 감사드립니다.